Comment organiser la littérature et les données probantes pour un article de synthèse
Pour organiser la littérature et les données probantes d’un article de synthèse, utilisez un système unique et traçable qui relie chaque étude à un identifiant stable, à ses métadonnées, à ses notes, aux données extraites et à leur localisateur dans la source. L’organisation précède la synthèse : elle doit rendre chaque élément facile à retrouver, comparer et vérifier sans transformer les catégories de travail en conclusions analytiques.
Plan de travail : de la source à un ensemble prêt pour la synthèse
Le flux le plus fiable consiste à garder une même identité d’étude à travers toutes les couches, puis à comparer, regrouper et vérifier les données sans perdre leur provenance.
- 1. Définir le système commun Unité d’enregistrement, identifiant stable, emplacements, convention de nommage et routine de mise à jour.
- 2. Créer une fiche par étude Métadonnées de citation, fichier source, notes et statut d’extraction aux mêmes emplacements logiques.
- 3. Aligner les champs comparables Méthode ou plan, population ou échantillon, résultats pertinents et limites dans une matrice adaptée à la question de synthèse.
- 4. Préserver la traçabilité Identifiant d’étude + localisateur dans la source + type d’élément enregistré pour pouvoir retrouver et vérifier chaque note ou donnée.
- 5. Grouper sans conclure trop tôt Catégories larges et étiquettes plus fines restent provisoires jusqu’à l’analyse et servent d’abord à la récupération.
- 6. Vérifier la préparation Exhaustivité, cohérence, doublons, traçabilité et états manquants explicites avant de passer à la synthèse.
- Cohérence
- Des informations comparables sont enregistrées avec des libellés, formats et règles stables.
- Traçabilité
- Chaque note ou donnée peut être reliée à l’étude correcte et, lorsque possible, à son emplacement précis dans la source.
- Frontière analytique
- L’organisation prépare la comparaison ; elle ne décide pas encore de la signification finale de l’ensemble des données probantes.
Les champs et les outils peuvent varier selon la question et le type de synthèse ; la règle stable est de conserver des enregistrements suffisamment cohérents pour une récupération, une comparaison et une vérification fiables.
Commencez par définir le système commun, puis alimentez-le avec des fiches d’étude reproductibles avant de construire les comparaisons et les contrôles de préparation.
Table des matières
Mettre en place un système cohérent pour organiser les études sélectionnées
Définissez le système d'organisation des études sélectionnées avant de commencer la prise de notes de recherche détaillée ou l'extraction des données probantes, afin que chaque fiche d'étude suive les mêmes règles de base pour l'identification, le stockage, la récupération et la mise à jour.
Un dispositif partagé favorise la cohérence et facilite la comparaison ultérieure, car les fiches sont créées dans le même flux de travail plutôt que d'être assemblées différemment pour chaque étude.
Cette organisation commence une fois que les enregistrements sources pertinents issus de la recherche bibliographique sont disponibles.
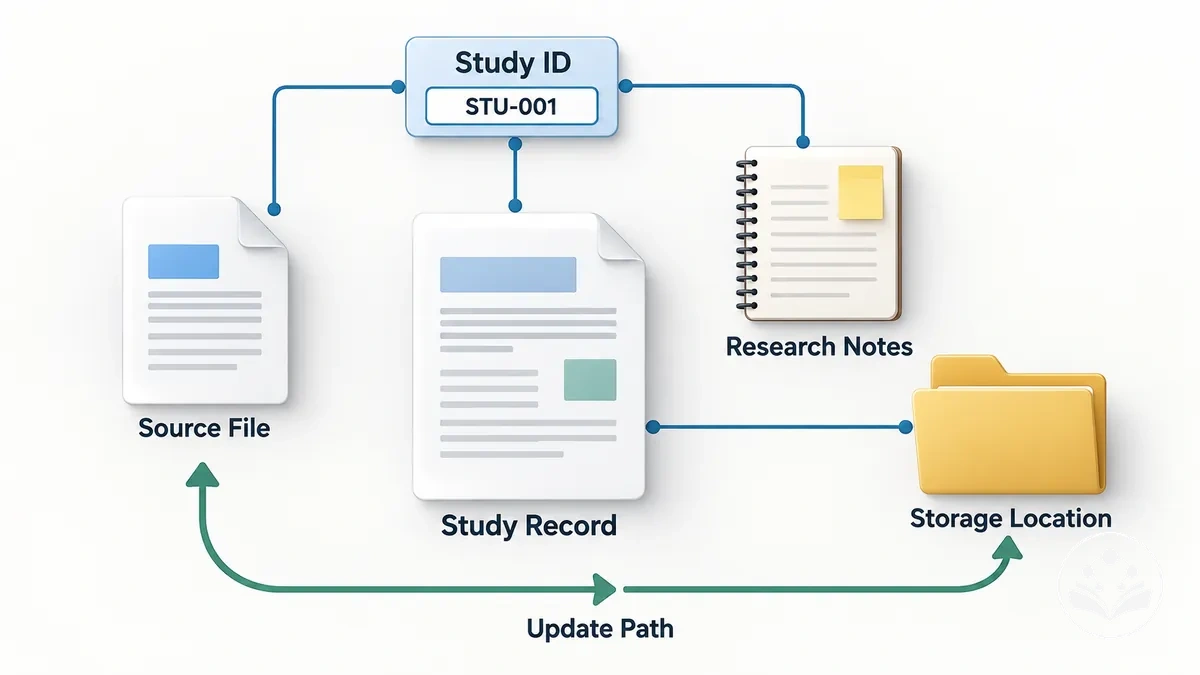
La séquence de mise en place établit comment les identifiants, les fiches, les fichiers et les notes se connectent avant que le système ne soit alimenté avec les études retenues après la sélection des études.
Le visuel ci-joint montre l'architecture de cette connexion, incluant l'identifiant stable d'étude, la fiche d'étude, l'emplacement du fichier, l'emplacement des notes et le chemin de mise à jour.
- Définissez l'unité d'enregistrement. Décidez ce que représente une fiche dans le cadre de la synthèse, par exemple une publication ou une étude liée à plusieurs rapports. L'unité appropriée dépend du type de synthèse et détermine la façon dont le matériel source connexe est regroupé.
- Attribuez un identifiant stable d'étude. Donnez à chaque fiche un identifiant qui reste inchangé à mesure que les notes et les données probantes sont ajoutées. Utiliser le même identifiant d'étude dans les fiches, les fichiers et les notes favorise la traçabilité et facilite la récupération.
- Choisissez les champs essentiels. Définissez les informations que chaque fiche d'étude doit contenir afin que des informations équivalentes soient saisies de manière cohérente et puissent être comparées ultérieurement. Les champs essentiels exacts peuvent varier selon la question de synthèse et le type de synthèse, établissez donc les champs communs sans anticiper l'extraction détaillée des données probantes.
- Définissez les emplacements des fichiers et des notes. Précisez où se trouvent les fichiers sources, les fiches d'étude et les notes de recherche, et comment ces emplacements se connectent à l'identifiant d'étude. Des emplacements de stockage définis réduisent les doublons inutiles et facilitent la détection du matériel égaré ou déconnecté.
- Définissez une convention de nommage. Utilisez une convention de nommage cohérente pour les fichiers et les fiches qui préserve l'identifiant stable d'étude et distingue les documents connexes lorsque nécessaire. La convention peut refléter l'environnement logiciel de l'équipe, à condition que la même règle soit appliquée dans l'ensemble du flux de travail choisi.
- Définissez une routine de mise à jour. Décidez comment les modifications apportées aux fiches d'étude, aux notes et aux données probantes stockées seront enregistrées et maintenues alignées. Pour les synthèses collaboratives, la routine peut également définir qui met à jour les fiches partagées et comment les modifications sont conciliées ; pour une synthèse individuelle, une routine plus simple peut suffire. Vérifiez qu'un identifiant d'étude peut être suivi de sa fiche à ses fichiers et notes associés avant que les fiches détaillées ne soient remplies.
Les identifiants stables et les champs essentiels cohérents favorisent la traçabilité car le matériel connexe reste associé à la même fiche d'étude, tandis que des règles de stockage et de nommage définies rendent la récupération plus prévisible.
Ces règles peuvent réduire les fichiers en double ou déconnectés et créer une base cohérente pour la comparaison sans nécessiter une application logicielle particulière.
Une fois que l'unité d'enregistrement, les identifiants, les champs essentiels, les emplacements de stockage, la convention de nommage et la routine de mise à jour sont définis, le système est prêt pour des fiches d'étude reproductibles.
Créer une fiche cohérente pour chaque étude
Chaque étude incluse nécessite une fiche d'étude avec la même structure de base, afin que ses informations d'identification, fichiers, notes et statut dans le flux de travail se trouvent à des endroits prévisibles.
Attribuez un identifiant stable d'étude et conservez des catégories fondamentales de fiche cohérentes entre les études.
Cette structure facilite la récupération et la vérifiabilité sans transformer la fiche en protocole complet d'extraction des données.
Le format de fiche reproductible couvre l'identifiant d'étude, les métadonnées de citation, l'emplacement du fichier, l'emplacement des notes et le statut d'extraction lorsque ce statut est pertinent pour le flux de travail de synthèse.
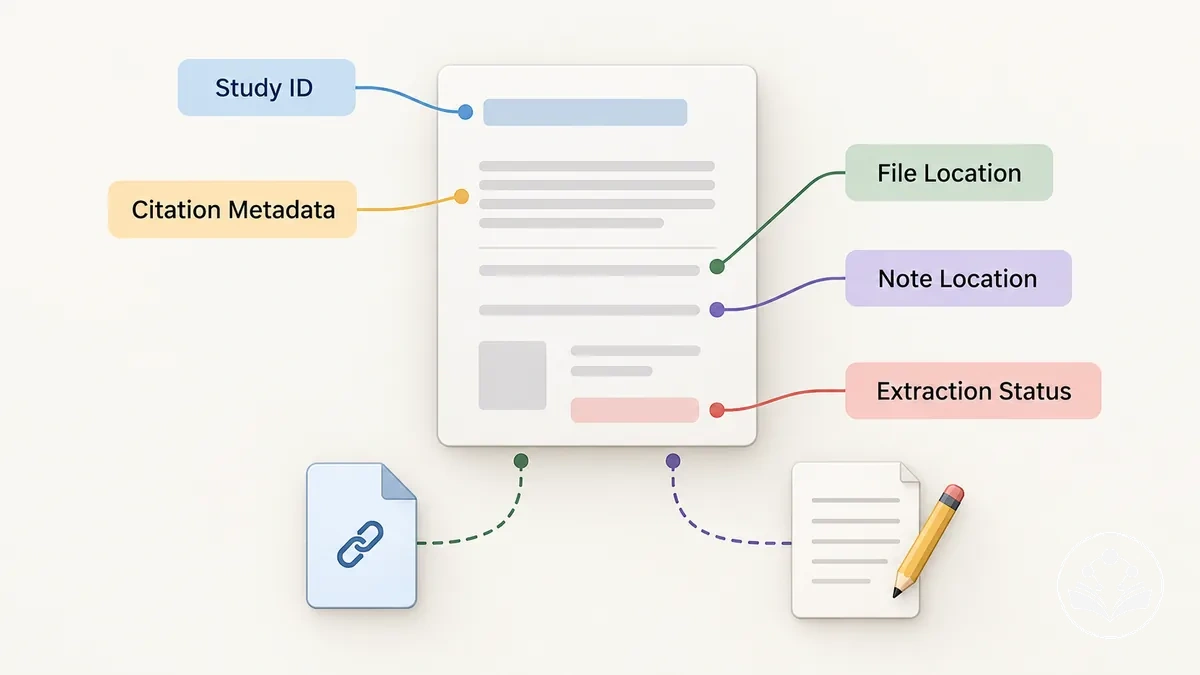
- Attribuez l'identifiant d'étude. Donnez à la fiche d'étude un identifiant unique et stable, et utilisez-le de façon cohérente avec les fichiers et notes associés pour faciliter la récupération et la déduplication.
- Enregistrez les métadonnées de citation. Stockez les informations de citation nécessaires pour identifier la source et la distinguer des autres entrées d'étude, afin de permettre une vérification cohérente des références et une bonne vérifiabilité.
- Enregistrez l'emplacement du fichier. Stockez l'emplacement du fichier source ou un autre emplacement stable utilisé dans le flux de travail de synthèse, afin que la source puisse être retrouvée à partir de la fiche d'étude.
- Enregistrez l'emplacement des notes. Stockez l'emplacement des notes de recherche et associez-le au même identifiant d'étude lorsque cela est possible, de manière à ce que les notes restent liées à la fiche source correcte.
- Mettez à jour le statut d'extraction lorsque cela est pertinent. Indiquez sur la fiche d'étude son statut d'extraction actuel lorsque le flux de travail de synthèse suit cette étape, afin que la fiche précise si une action est encore nécessaire pour l'extraction des données probantes.
Par exemple, un identifiant hypothétique tel que STU-014 peut apparaître dans la fiche d'étude, dans le nom de son fichier source et dans la fiche de notes correspondante.
Réutiliser le même identifiant dans ces différents emplacements rend les documents connexes plus faciles à retrouver et à relier lors des mises à jour ou des comparaisons ultérieures.
Séparer les détails de source, les caractéristiques d'étude et les données probantes
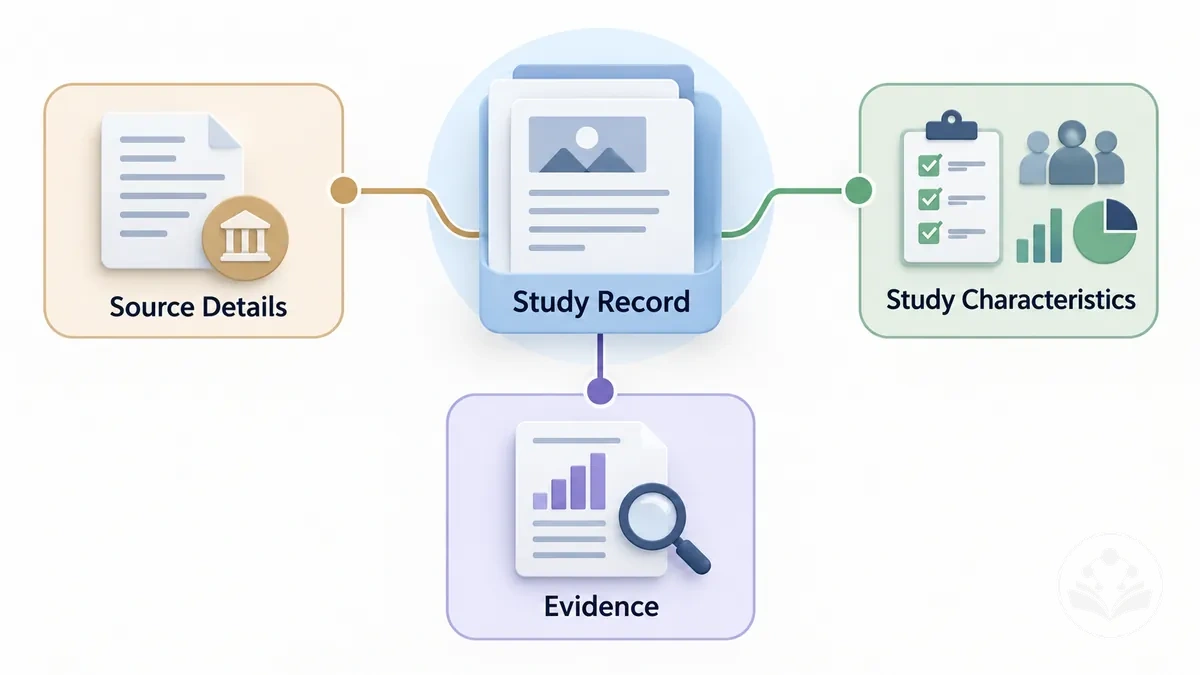
Les détails de source, les caractéristiques d'étude et les données probantes sont trois classes d'information distinctes dans une fiche d'étude.
Les détails de source contiennent les informations bibliographiques et les métadonnées de citation qui identifient la source et préservent sa provenance.
Les caractéristiques d'étude décrivent l'étude par des attributs tels que le plan, le cadre, la population ou l'échantillon, tandis que les données probantes capturent les résultats ou les données pertinents pour la question de synthèse.
Maintenir ces classes distinctes empêche que les informations de provenance, les descripteurs d'étude et les données probantes pertinentes pour la synthèse ne deviennent une note indifférenciée.
Les détails de source identifient et localisent une étude ; les caractéristiques d'étude la décrivent ; les données probantes capturent ce qui est pertinent pour la question de synthèse.
Cette séparation favorise la traçabilité en maintenant la provenance liée à la source, la comparaison en maintenant les attributs descriptifs de l'étude distincts, et l'extraction ultérieure en séparant les résultats pertinents pour la synthèse des données d'identification.
Le diagramme rend visibles les limites des composants tout en montrant que les trois classes d'information appartiennent à la même fiche d'étude.
| Classe d'information | Champs typiques | Raison de la séparation |
|---|---|---|
| Détails de source | Détails bibliographiques, métadonnées de citation, informations de référence, provenance | Identifie et localise la source tout en rendant son origine traçable. |
| Caractéristiques d'étude | Plan, cadre, population ou échantillon | Décrit l'étude et facilite la comparaison des descripteurs d'étude. |
| Données probantes | Résultats ou données pertinents pour la question de synthèse | Maintient les données probantes extraites distinctes de l'identification de la source et des caractéristiques descriptives pour l'extraction et l'interprétation ultérieures. |
Les champs exacts des caractéristiques d'étude et des données probantes doivent être adaptés à la discipline, à la question de synthèse et au plan de synthèse plutôt que traités comme une taxonomie fixe.
Les trois classes d'information restent distinctes même lorsque les champs spécifiques au sein de chaque classe changent.
Construire une matrice de littérature pour organiser et comparer les données probantes
Une matrice de littérature est une méthode d'organisation et de comparaison qui place des informations comparables issues de plusieurs études ou sources dans une grille commune.
Chaque étude reste une fiche de données probantes distincte tandis que des champs de données probantes partagés rendent les attributs et résultats pertinents visibles côte à côte.
La matrice facilite la comparaison avant la synthèse sans réaliser la synthèse elle-même.
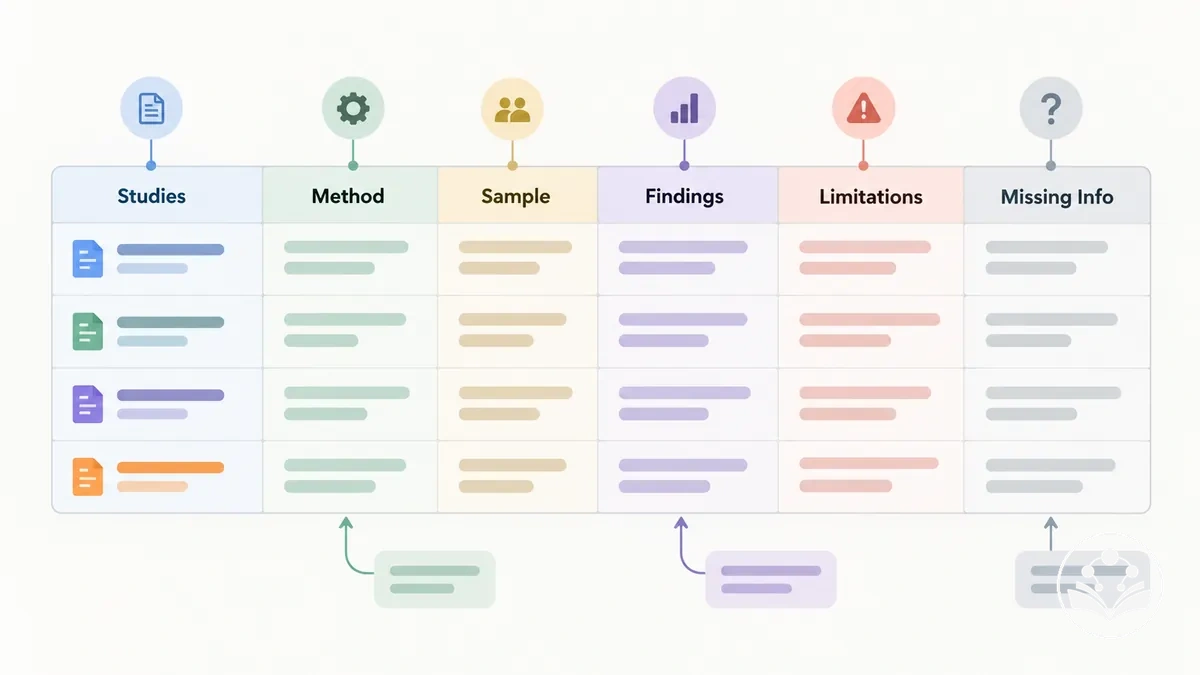
Les lignes d'étude et les colonnes partagées offrent une structure cohérente pour la comparaison : chaque ligne peut représenter une étude, tandis que les colonnes peuvent enregistrer des champs tels que la méthode ou le plan, l'échantillon ou la population, les résultats pertinents et les limites.
Cette structure suit la relation allant de l'étude au champ de données probantes sélectionné, puis à la valeur ou au résultat enregistré, rendant ainsi les informations équivalentes plus faciles à examiner entre les études.
L'exemple annoté ci-joint montre comment plusieurs études s'alignent sur des colonnes de comparaison partagées sans reproduire chaque entrée du tableau.
| Étude | Méthode/Plan | Échantillon/Population | Résultat pertinent | Limite/Note |
|---|---|---|---|---|
| Étude A | Entretiens qualitatifs | Participants adultes | Thème récurrent rapporté | Cadre unique |
| Étude B | Enquête transversale | Échantillon communautaire | Schéma différent rapporté | Champ de données probantes non rapporté |
| Étude C | Étude mixte | Population d'étude définie | Résultat connexe rapporté | Différence méthodologique notée |
Des schémas peuvent devenir visibles lorsque des résultats comparables reviennent dans plusieurs lignes, tandis que les différences de méthodes, d'échantillons ou de résultats rapportés peuvent être localisées sans fondre les études en une seule conclusion.
Les informations manquantes deviennent visibles lorsqu'un champ de données probantes partagé n'a pas de valeur rapportée pour une étude.
Ces signaux identifient du matériel pour une interprétation ultérieure, mais ils n'établissent pas par eux-mêmes des thèmes, ne résolvent pas des contradictions et ne déterminent pas les conclusions de la synthèse.
L'orientation de la matrice et la sélection des champs peuvent varier selon la question de synthèse, les données probantes disponibles et la méthode de travail ; les études peuvent être disposées différemment tant que les informations équivalentes restent comparables de façon cohérente.
La matrice de littérature fonctionne donc comme une méthode structurée pour organiser et comparer les données probantes, tandis que l'interprétation approfondie et la synthèse restent des tâches analytiques distinctes.
Choisir les champs de la matrice qui correspondent à la question de synthèse
Les champs de la matrice doivent être inclus lorsqu'ils soutiennent matériellement la question de synthèse ou permettent une comparabilité significative entre les études.
La pertinence des champs dépend de la synthèse : une colonne utile pour une synthèse peut être non essentielle pour une autre.
Une sélection cohérente des champs détermine quels descripteurs d'étude, variables, résultats, thèmes ou autres données probantes peuvent ensuite être comparés, sans supposer qu'un plus grand nombre de champs produit une meilleure matrice.
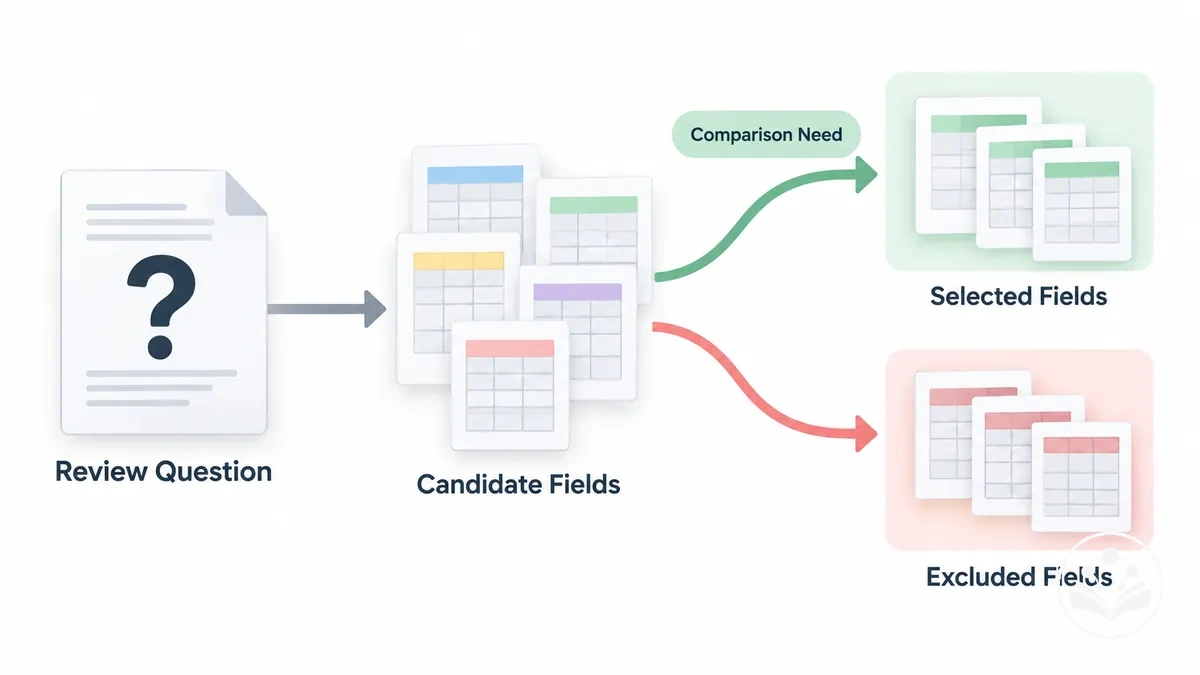
Les critères de sélection relient chaque champ candidat à une condition d'inclusion et à une implication analytique.
Le diagramme ci-joint illustre cette décision fondée sur la pertinence en reliant la question de synthèse aux champs candidats, aux champs pertinents sélectionnés et aux champs non essentiels exclus.
- Pertinence par rapport à la question de synthèse : Inclure un champ lorsque sa valeur aide directement à répondre à la question de synthèse ou à évaluer une comparaison définie ; autrement, il peut ajouter de l'information sans contribuer à l'analyse prévue.
- Cohérence et comparabilité : Inclure un champ lorsque des informations équivalentes peuvent être identifiées dans les études pertinentes suffisamment pour soutenir une comparaison significative ; des données incohérentes ou manquantes peuvent limiter la façon dont le champ est comparé.
- Interprétabilité : Inclure un champ lorsque ses valeurs ont un sens suffisamment clair et cohérent dans le contexte de la synthèse ; des catégories ambiguës peuvent rendre les différences entre les études difficiles à interpréter.
- Faisabilité de l'extraction : Inclure un champ lorsque les informations requises peuvent être localisées et extraites des sources disponibles avec une cohérence suffisante pour l'usage prévu ; des informations mal rapportées peuvent produire des données manquantes substantielles.
- Champs essentiels : Utiliser les identifiants et les descripteurs d'étude lorsqu'ils soutiennent l'identification d'une étude ou une comparaison qui doit rester cohérente entre les fiches.
- Champs spécifiques à la question : Utiliser les variables, les résultats, les thèmes ou les notes liées à la qualité lorsqu'ils correspondent directement aux objectifs de la synthèse et aux comparaisons prévues.
Par exemple, la durée d'une intervention peut être un champ utile de la matrice lorsque la question de synthèse compare les résultats selon la durée d'exposition, alors que l'institution d'affiliation de l'auteur peut être intéressante mais non essentielle lorsqu'elle n'a pas de relation définie avec cette comparaison.
La décision d'inclure un champ doit donc suivre la pertinence, la comparabilité, la cohérence, l'interprétabilité et la faisabilité de l'extraction plutôt qu'un ensemble fixe de colonnes.
Enregistrer les méthodes, échantillons, résultats et limites de façon cohérente
Les fiches d'étude comparables doivent utiliser les mêmes catégories descriptives pour les méthodes, les échantillons, les résultats et les limites, tout en préservant ce que chaque source rapporte réellement.
Des libellés cohérents peuvent rendre les informations équivalentes plus faciles à parcourir, mais ils ne doivent pas modifier le sens d'un plan d'étude, d'une population, d'un résultat ou d'une contrainte d'étude.
Les unités peuvent être normalisées lorsqu'elles représentent la même quantité, tandis que les qualificatifs contextuels doivent rester lorsqu'ils sont nécessaires pour interpréter des informations propres à une étude.
Les quatre classes d'information doivent être enregistrées en parallèle afin que les lecteurs puissent localiser des attributs comparables sans traiter des études hétérogènes comme si elles rapportaient des informations identiques.
- Méthode/Plan : Enregistrer les méthodes ou le plan d'étude rapportés en utilisant des libellés cohérents lorsque la terminologie peut être alignée sans en changer le sens ; conserver la description du plan propre à la source lorsqu'un libellé plus large effacerait une distinction pertinente.
- Échantillon/Population : Enregistrer les informations sur l'échantillon ou la population nécessaires à la comparaison, y compris la taille rapportée, le cadre ou les caractéristiques des participants lorsque cela est pertinent ; utiliser des unités et des libellés cohérents lorsque des mesures équivalentes sont rapportées, tout en conservant les qualificatifs contextuels qui affectent l'interprétation.
- Résultats : Enregistrer les résultats ou les données rapportées qui correspondent à la question de synthèse et distinguer les données probantes rapportées par les auteurs de l'interprétation ultérieure du rédacteur de la synthèse ; normaliser les unités ou les libellés de résultats équivalents uniquement lorsque cela préserve le sens original.
- Limites : Enregistrer les limites rapportées par l'étude et conserver les qualificatifs qui expliquent le contexte dans lequel elles s'appliquent ; maintenir distincte toute préoccupation identifiée par le rédacteur de la synthèse afin qu'une limite inférée ne soit pas présentée comme un fait rapporté.
Par exemple, deux études hétérogènes peuvent conserver des libellés de plan d'étude et des descriptions de population différents tout en utilisant les mêmes catégories d'enregistrement pour Méthode/Plan, Échantillon/Population, Résultats et Limites.
Cette approche favorise la comparabilité au niveau des catégories sans forcer des données probantes différentes dans des valeurs identiques ni écarter le contexte propre à chaque étude.
Utiliser un tableau structuré d'extraction des données probantes lorsque des données d'étude détaillées doivent être capturées
Un tableau structuré d'extraction des données probantes se justifie lorsqu'une synthèse nécessite une extraction systématique d'informations répétées et spécifiques à la synthèse à partir des études incluses, au-delà de la comparaison plus large permise par une matrice de littérature générale.
Utiliser la même structure d'extraction pour l'ensemble des études incluses favorise la cohérence et la reproductibilité en rendant explicites les informations sélectionnées pour la capture.
Cela peut réduire la capture sélective en définissant les champs pertinents à l'avance, mais ce niveau de détail n'est pas nécessaire pour toute synthèse narrative.
Le tableau d'extraction des données probantes doit capturer des champs qui servent la question de synthèse ou permettent de vérifier les informations extraites par rapport à leur source.
Un identifiant d'étude relie chaque ligne à l'étude incluse, tandis que les informations sur la population ou l'échantillon enregistrent le groupe d'étude pertinent.
L'intervention ou l'exposition s'applique uniquement lorsque le plan de synthèse en examine une, et le résultat ou la mesure identifie ce qui a été évalué.
Le résultat enregistre les données probantes pertinentes rapportées, tandis que l'emplacement des données préserve la provenance en identifiant où ces données probantes peuvent être vérifiées dans la source.
Les notes d'extraction peuvent conserver les qualificatifs contextuels nécessaires ou documenter les décisions d'extraction sans transformer ces notes en résultat de synthèse.
| ID d'étude | Population/Échantillon | Intervention/Exposition | Résultat/Mesure | Résultat | Emplacement des données | Note d'extraction |
|---|---|---|---|---|---|---|
| Étude A | Population d'étude rapportée | À enregistrer lorsque applicable au plan de synthèse | Mesure pertinente pour la synthèse | Résultat rapporté pertinent pour la question de synthèse | Page source, tableau, figure ou section | Qualificatif pertinent ou décision d'extraction |
| Étude B | Population d'étude rapportée | Non applicable lorsque le plan de synthèse n'examine pas d'intervention ou d'exposition | Mesure pertinente pour la synthèse | Résultat rapporté pertinent pour la question de synthèse | Page source, tableau, figure ou section | Qualificatif pertinent ou décision d'extraction |
Lorsque le processus d'extraction est complexe, tester ou vérifier la structure d'extraction sur un petit ensemble d'études incluses avant une utilisation à grande échelle pour déterminer si les champs correspondent à la question de synthèse et peuvent être appliqués de façon cohérente.
Adapter les champs qui créent une ambiguïté, omettent un contexte nécessaire ou ne soutiennent pas la vérification, tout en conservant la frontière entre l'organisation des données extraites et la synthèse formelle des données probantes.
Relier les notes de recherche à leurs sources
Toute note de recherche doit rester liée à la source et aux données probantes qu'elle décrit, afin que son attribution puisse être vérifiée ultérieurement sans avoir à reconstruire la piste de recherche.
La note doit identifier l'étude, renvoyer au localisateur dans la source le plus stable disponible et préciser si le matériel enregistré est une citation, une paraphrase ou une interprétation du chercheur.
Ce lien favorise la provenance et la vérifiabilité sans laisser entendre qu'un localisateur prouve la validité de l'affirmation sous-jacente.
La connexion note-source peut être établie en quatre étapes reproductibles qui préservent la provenance et réduisent les erreurs d'attribution.
- Attribuer ou réutiliser l'identifiant d'étude. Lier la note de recherche au même identifiant d'étude que celui utilisé pour la fiche source, afin que la note puisse être rattachée à la bonne étude et vérifiée par rapport à cette source.
- Capturer la note. Enregistrer les informations pertinentes clairement et maintenir le contenu rapporté par la source distinct de l'interprétation ultérieure du chercheur, afin que la base des données probantes reste identifiable.
- Enregistrer un localisateur dans la source. Ajouter le localisateur le plus stable disponible, tel qu'une page, une section, une figure, un tableau, un paragraphe ou un autre emplacement propre à la source, afin que les données probantes puissent être localisées et vérifiées directement lorsque nécessaire.
- Indiquer le type d’élément. Marquer la note comme citation, paraphrase ou interprétation du chercheur, afin que les données probantes rapportées restent distinctes du commentaire analytique du rédacteur de la synthèse lors d'une utilisation ultérieure.
Une note illustrative traçable pourrait se présenter ainsi : ID d'étude STU-021 — paraphrase — p.
14, Tableau 2, suivie de la note pertinente ; une note détachée telle que les participants se sont améliorés après l'intervention sans identifiant d'étude, localisateur dans la source ou étiquette de type d’élément ne peut pas être vérifiée ou attribuée de manière fiable ultérieurement.
Avant d'utiliser une note de recherche dans une analyse ou une rédaction, vérifier que son identifiant, son localisateur et son type d’élément la relient toujours à la source de référence.
Conserver la traçabilité des notes et des données probantes extraites jusqu'aux études individuelles
La traçabilité est la capacité de remonter d’une note de recherche ou d’une valeur extraite jusqu’à l’étude individuelle exacte et, lorsque cela est possible, jusqu’à l’emplacement précis qui la soutient.
Chaîne minimale de traçabilité
- Identifiant stable d’étude
- Relie la note ou la donnée extraite à la bonne fiche source, même lorsque les fichiers et les notes sont stockés dans des outils différents.
- Localisateur dans la source
- Indique où vérifier l’élément : page si la pagination est stable, ou sinon section, figure, tableau, paragraphe ou autre marqueur fiable.
- Type d’élément enregistré
- Distingue une citation, une paraphrase, une donnée extraite ou une interprétation afin de ne pas confondre le constat de la source avec l’interprétation du rédacteur.
Exemple traçable : ID d’étude STU-021 — Tableau 2 — donnée extraite.
Grouper et étiqueter les données probantes pour l'analyse ultérieure
Grouper et étiqueter les données probantes avec des catégories stables et provisoires afin que les résultats connexes puissent être récupérés ensemble pour une analyse ultérieure sans traiter ces catégories comme des conclusions de synthèse définitives.
Le regroupement rend les schémas récurrents plus faciles à examiner dans l'ensemble des données probantes organisées tout en préservant les études et les résultats individuels qui les soutiennent.
Les dimensions de regroupement pertinentes peuvent inclure un thème, un concept, une population, une méthode, un résultat, un contexte ou une période temporelle lorsque cette dimension est matériellement liée à la question de synthèse.
La séquence de regroupement passe des attributs récurrents aux étiquettes provisoires, puis à l'affectation des données probantes, chaque étape étant vérifiée pour son utilité continue.
- Identifier les dimensions récurrentes. Examiner les données probantes organisées pour y trouver des thèmes, concepts, populations, méthodes, résultats, contextes ou périodes temporelles récurrents qui pourraient soutenir l'analyse ultérieure. Vérifier que chaque dimension proposée a une relation définie avec la question de synthèse plutôt que de simplement apparaître de manière répétée.
- Définir des étiquettes stables. Donner à chaque groupe utile une étiquette concise qui décrit l'attribut partagé sans encoder une conclusion analytique définitive. Vérifier que l'étiquette peut être appliquée de façon cohérente et ne crée pas une catégorie ponctuelle pour des données probantes qui manquent d'une relation de regroupement significative.
- Affecter les données probantes aux groupes pertinents. Placer chaque résultat ou élément de données probantes pertinent sous l'étiquette applicable afin que le matériel connexe puisse être récupéré ensemble. Vérifier les données probantes elles-mêmes plutôt que de supposer qu'une étude appartient à un seul groupe, car différents résultats d'une même étude peuvent soutenir différents groupes analytiquement pertinents.
- Examiner l'utilité des étiquettes. Vérifier si les groupes restent suffisamment distincts pour soutenir la récupération et la comparaison à mesure que davantage de données probantes sont affectées. Rechercher des étiquettes qui se chevauchent inutilement, fragmentent des données probantes étroitement liées ou ne représentent plus une distinction utile pour la question de synthèse, et les affiner si nécessaire.
Par exemple, une étude pourrait apporter des données probantes à un groupe de population et à un groupe de résultats lorsque des résultats distincts de cette étude sont pertinents pour les deux dimensions ; les affectations identifient des chemins de récupération plutôt que de déclarer des thèmes définitifs.
Les groupes préliminaires de données probantes ne sont pas automatiquement la structure finale du manuscrit, et le regroupement pour la récupération et l'analyse ultérieure est distinct du choix de l'organisation thématique ou chronologique pour la synthèse écrite.
Les groupes doivent rester des aides organisationnelles provisoires jusqu'à ce que l'analyse ultérieure détermine comment les données probantes doivent être interprétées et présentées.
Utiliser des catégories et des étiquettes pour conserver les données probantes connexes ensemble
Les catégories et les étiquettes créent une couche de récupération contrôlée sur les données probantes organisées, sans transformer les regroupements de travail en thèmes analytiques définitifs.
Distinction à conserver
Catégorie
Regroupement large utilisé pour structurer une dimension majeure, par exemple Population.
Étiquette
Attribut ou sous-thème plus fin et réutilisable, par exemple adolescents, adultes âgés ou aidants. Plusieurs étiquettes peuvent s’appliquer au même élément lorsque plusieurs dimensions sont pertinentes.
Le système d’étiquetage doit utiliser des règles explicites pour le nommage, la granularité, la cohérence, le contrôle des synonymes et les étiquettes multiples, afin que les libellés restent réutilisables sans fragmenter artificiellement les données probantes.
- Nommage : Utiliser des libellés clairs et descriptifs qui reflètent l'attribut des données probantes regroupées, et éviter les abréviations qui pourraient être ambiguës lors d'une récupération ultérieure.
- Granularité : Maintenir les catégories suffisamment larges pour rassembler les données probantes connexes et les étiquettes suffisamment spécifiques pour distinguer les attributs réutilisables ; des étiquettes excessivement étroites peuvent fragmenter les données probantes en libellés ponctuels.
- Cohérence : Appliquer le même libellé au même concept dans l'ensemble des données probantes afin que la récupération ne dépende pas de variations de formulation.
- Contrôle des synonymes : Choisir un libellé préféré pour les termes équivalents et l'appliquer de façon cohérente ; des synonymes qui se chevauchent peuvent diviser des données probantes connexes entre plusieurs chemins de récupération distincts.
- Étiquettes multiples : Appliquer plusieurs étiquettes lorsqu'un résultat se rapporte véritablement à plusieurs attributs réutilisables, à condition que chaque étiquette ait un objectif défini et ne code pas une conclusion non étayée.
Le niveau de granularité utile dépend de l’ensemble des données probantes et du besoin de récupération ; les catégories et les étiquettes doivent donc rester des libellés organisationnels contrôlés plutôt qu’une taxonomie universelle ou un résultat analytique.
Coordonner la gestion des références, les fichiers et les fiches de données probantes
Un gestionnaire de références, les fichiers sources, les notes de recherche et les fiches de données probantes remplissent des fonctions différentes, mais ils doivent fonctionner comme des couches connectées du même flux de travail d'enregistrement de la recherche.
Le gestionnaire de références organise principalement les métadonnées de citation et les relations entre les sources, les fichiers préservent les documents consultés, les notes de recherche capturent les annotations et l'interprétation liées aux sources, et les fiches de données probantes portent les informations sélectionnées pour la comparaison avec la question de synthèse.
La coordination provient de l'utilisation d'un identifiant stable d'étude ou d'une clé de citation à travers ces couches plutôt que d'attendre d'un seul dépôt qu'il exécute toutes les fonctions.
La division fonctionnelle aide à maintenir le contrôle bibliographique séparé des données probantes spécifiques à la question tout en préservant les connexions entre les fiches.
Un logiciel de gestion des références tel que Zotero peut, selon la version et la configuration du logiciel, prendre en charge les métadonnées de citation, les collections, les étiquettes, les pièces jointes et les annotations.
Le stockage des fichiers sources contient des PDF ou d'autres fichiers de documents, tandis que les notes de recherche conservent les observations contextuelles et les localisateurs dans la source associés à ces documents.
Une fiche ou matrice de données probantes porte les attributs d'étude et les données probantes extraites nécessaires à la comparaison spécifique à la synthèse.
L'identifiant d'étude fournit le point de connexion qui permet aux informations détenues dans différents outils ou emplacements d'être associées à la même étude.
| Couche du flux de travail | Rôle principal | Contenu typique | Clé de connexion |
|---|---|---|---|
| Gestionnaire de références | Organiser les fiches bibliographiques et les relations entre les sources | Métadonnées de citation, collections, étiquettes, pièces jointes et annotations (lorsque pris en charge) | Identifiant d'étude ou clé de citation associé à la fiche de référence |
| Fichiers sources | Stocker les documents utilisés comme sources de données probantes | PDF ou autres documents sources, avec un nommage cohérent des fichiers et des emplacements de stockage | Identifiant d'étude ou clé de citation dans le nom du fichier ou la fiche associée |
| Notes de recherche | Conserver des notes contextuelles et l'interprétation liées aux sources | Annotations, paraphrases, interprétation et localisateurs dans la source | Identifiant d'étude ou clé de citation lié à la note |
| Fiche/matrice de données probantes | Organiser les informations spécifiques à la synthèse pour la comparaison | Attributs d'étude pertinents, résultats extraits et champs de données probantes spécifiques à la question | Identifiant d'étude ou clé de citation enregistré avec la ligne de la matrice |
Par exemple, un identifiant d'étude hypothétique tel que STU-021 peut être associé à la fiche de référence, inclus dans le nom du fichier PDF, attaché aux notes de recherche et saisi dans la ligne correspondante de la fiche ou matrice de données probantes.
L'identifiant partagé permet à ces fiches d'être connectées même lorsqu'elles sont stockées dans différents outils ou emplacements.
Chaque couche peut conserver son rôle principal, l'identifiant coordonné préservant la relation entre la référence, les fichiers, les notes et les données probantes extraites.
Vérifier les données probantes organisées avant de passer à la synthèse
Avant la synthèse, vérifiez les données probantes organisées afin que les fiches manquantes, les champs incohérents, les doublons, les liens source rompus ou les étiquettes ambiguës ne soient pas transportés dans la comparaison ultérieure.
Un ensemble est prêt pour l’analyse lorsque les fiches requises sont suffisamment complètes, structurées de façon cohérente et traçables. Une valeur peut rester absente si la source ne la rapporte pas ou si le champ n’est pas applicable, mais cet état doit être explicite plutôt que deviné.
La vérification porte sur la couverture des études, l’exhaustivité, le contrôle des doublons, la cohérence, la traçabilité, la provenance, les catégories ou étiquettes et les valeurs manquantes non résolues. Chaque contrôle doit mener à un signal de réussite ou à une action corrective ; il s’agit d’un contrôle de préparation du système, non d’une notation de la qualité du manuscrit ni d’une évaluation méthodologique.
Contrôles avant la synthèse
- Couverture des études : Vérifier que chaque étude destinée à l'analyse a une fiche de données probantes correspondante. La vérification réussit lorsque les études incluses peuvent être comptabilisées dans les données probantes organisées ; si une fiche est absente ou ne peut être reconciliée, la restaurer, la résoudre ou la signaler explicitement avant de continuer.
- Exhaustivité des champs requis : Vérifier que les champs définis comme nécessaires pour la synthèse ont été renseignés lorsque la source fournit l'information requise. La vérification réussit lorsque l'information requise est enregistrée ou qu'une absence justifiée est explicitement marquée ; enquêter sur les blancs inexpliqués plutôt que de les combler par inférence.
- Contrôle des doublons : Vérifier que les fiches en double ou les multiples rapports associés à une même étude n'ont pas été traités involontairement comme des données probantes indépendantes. La vérification réussit lorsque les relations entre les fiches sont claires ; fusionner, lier ou autrement concilier les doublons non intentionnels tout en conservant les fiches sources distinctes lorsqu'elles sont réellement nécessaires.
- Cohérence des champs : Vérifier que les informations équivalentes sont enregistrées avec des libellés, catégories, unités et qualificatifs contextuels cohérents lorsque la normalisation préserve le sens source. La vérification réussit lorsque les champs comparables peuvent être interprétés de façon cohérente ; corriger les entrées incohérentes ou documenter les différences propres à chaque étude qui doivent rester distinctes.
- Lien note-source : Vérifier que les notes de recherche conservent l'identifiant d'étude et un localisateur dans la source approprié lorsqu'il est disponible. La vérification réussit lorsqu'une note peut être retracée jusqu'à sa source de référence ; reconnecter ou signaler les notes détachées avant de les traiter comme prêtes pour l'analyse.
- Provenance des données probantes : Vérifier que les résultats ou les valeurs extraits restent associés à l'étude et à l'emplacement source dont ils proviennent. La vérification réussit lorsque la piste des données probantes soutient la vérification ; restaurer la provenance manquante ou signaler l'élément de donnée probante lorsque son origine ne peut être établie.
- Cohérence des catégories ou étiquettes : Vérifier que les catégories et les étiquettes sont appliquées de façon cohérente et que les libellés qui se chevauchent ne fragmentent pas inutilement les données probantes connexes. La vérification réussit lorsque les concepts équivalents utilisent les libellés prévus ; concilier les synonymes ambigus ou documenter les distinctions justifiées.
- Valeurs manquantes non résolues : Vérifier les valeurs manquantes restantes pour déterminer si elles reflètent une absence de rapport, une non-applicabilité ou un problème non résolu dans la fiche. La vérification réussit lorsque chaque lacune matérielle a un statut explicite ; résoudre ce qui peut l'être et signaler les manques justifiés sans deviner de valeur.
Les fiches ambiguës ou incomplètes doivent être résolues lorsque la source le permet, documentées lorsqu'une distinction doit rester, ou explicitement signalées lorsque l'information ne peut être établie.
Une lacune signalée peut rester dans un ensemble de données prêt pour l'analyse lorsque son statut est clair et que le plan de synthèse n'exige pas de valeur résolue pour ce champ.
Une fois que les fiches requises sont suffisamment complètes, cohérentes et traçables, et que leurs états non résolus sont explicites, l’ensemble de données organisé est prêt pour la synthèse des données probantes.
Vérifier l'exhaustivité, la cohérence et la traçabilité des sources
L'exhaustivité, la cohérence et la traçabilité des sources sont des critères de préparation distincts car ils détectent des problèmes différents dans les données probantes organisées.
L'exhaustivité vérifie si les fiches requises et les champs requis sont présents ou explicitement assignés à un état manquant approprié.
La cohérence vérifie si les informations équivalentes suivent des libellés, formats et règles de codage stables, tandis que la traçabilité des sources vérifie si les données probantes et les notes conservent un lien source vérifiable avec l'étude individuelle.
Les critères doivent être interprétés selon le plan de synthèse plutôt qu'en supposant que chaque champ doit contenir une valeur substantielle.
Un blanc peut représenter une information manquante dans la source, non applicable ou pas encore extraite, et ces états ont des implications correctives différentes.
Des libellés et des règles de codage stables favorisent la cohérence lorsque des informations équivalentes sont enregistrées de la même manière, tandis que des différences justifiées propres à chaque étude peuvent rester distinctes.
La traçabilité des sources est acceptable lorsqu'un élément de donnée probante ou une note peut être relié, par un identifiant d'étude et un lien ou localisateur dans la source, à la fiche de référence.
Ces critères soutiennent un jugement de préparation sans imposer un seuil de complétude universel.
| Critère | Élément à inspecter | État acceptable | Orientation corrective |
|---|---|---|---|
| Exhaustivité | Fiches requises, champs requis et statut des valeurs manquantes | Les informations requises sont enregistrées lorsqu'elles sont disponibles, et les valeurs absentes sont explicitement étiquetées comme manquantes dans la source, non applicables ou pas encore extraites lorsque cette distinction s'applique | Terminer l'extraction inachevée, restaurer les fiches requises manquantes, ou assigner l'étiquette d'état manquant correcte sans deviner une valeur |
| Cohérence | Libellés, formats, unités et règles de codage stables utilisés pour les informations équivalentes | Les informations équivalentes suivent les mêmes règles d'enregistrement, tandis que les différences justifiées propres à chaque source restent clairement distinguées | Normaliser les libellés ou formats incohérents lorsque le sens est préservé, ou documenter pourquoi une représentation différente est nécessaire |
| Traçabilité des sources | Liens entre les données probantes, les notes de recherche, l'identifiant d'étude et l'emplacement source de référence | Chaque élément matériel peut être retracé jusqu'à l'étude individuelle et, lorsqu'il est disponible, jusqu'à un localisateur dans la source fiable | Restaurer le lien source ou le localisateur manquant, reconnecter l'élément à la fiche d'étude correcte, ou signaler explicitement l'élément lorsque la provenance ne peut être établie |
Par exemple, si un champ de résultat est vide parce que la source ne rapporte jamais ce résultat, la correction consiste à étiqueter la valeur manquante dans la source, non à inférer un résultat ou à traiter la fiche comme automatiquement incomplète.
En revanche, un blanc marqué pas encore extrait identifie un travail inachevé qui doit être terminé avant que la fiche soit traitée comme prête pour l'analyse.