Literatur und Evidenz für einen Übersichtsartikel organisieren
Organisieren Sie Literatur und Evidenz für einen Übersichtsartikel, indem Sie jeder eingeschlossenen Studie eine stabile Kennung geben, Quellenangaben, Studienmerkmale und reviewrelevante Evidenz getrennt erfassen und jede Notiz sowie jeden extrahierten Wert mit einer überprüfbaren Fundstelle verbinden. Der Bestand ist für die Synthese vorbereitet, wenn erforderliche Einträge ausreichend vollständig, konsistent und quellenrückverfolgbar sind; fehlende Werte werden als „in der Quelle nicht berichtet“, „nicht anwendbar“ oder „noch nicht extrahiert“ gekennzeichnet, statt ergänzt oder erschlossen zu werden.
Arbeitsmodell: von der Quelle zur synthesebereiten Evidenz
Der Organisationsprozess folgt einem durchgehenden Prüfpfad: Jede Information bleibt mit ihrer Studie und Fundstelle verbunden, während gemeinsame Felder den Vergleich vorbereiten.
-
Eintragseinheit und Kennung festlegenDefinieren Sie, ob ein Eintrag eine Publikation oder eine Studie mit mehreren Berichten repräsentiert, und vergeben Sie eine stabile Studien-ID oder einen eindeutigen Zitationsschlüssel.
-
Informationsklassen trennenHalten Sie Quellenangaben, Studienmerkmale und reviewrelevante Evidenz als getrennte, aber verbundene Felder desselben Studieneintrags.
-
Vergleichsfelder strukturierenNutzen Sie eine Literaturmatrix für gemeinsame Vergleichsfelder und eine detaillierte Evidenzextraktionstabelle, wenn der Review wiederholte, reviewspezifische Daten systematisch benötigt.
-
Notizen rückverfolgbar haltenVerbinden Sie jede Notiz oder jeden Datenpunkt mit Studienkennung, Fundstelle und Evidenztyp, damit Quelle und Status später überprüfbar bleiben.
-
Evidenz vorläufig gruppierenVerwenden Sie stabile Kategorien und Tags für den Abruf zusammengehöriger Evidenz, ohne diese Bezeichnungen bereits als endgültige Synthesethemen zu behandeln.
-
Synthesebereitschaft prüfenPrüfen Sie Abdeckung, Vollständigkeit, Konsistenz und Quellenrückverfolgbarkeit. Offene Werte müssen einen expliziten Status haben, statt stillschweigend ergänzt zu werden.
Die Organisation liegt zwischen Studienauswahl und Synthese: Sie macht Material auffindbar, vergleichbar und überprüfbar, ohne bereits zu entscheiden, was die Evidenz insgesamt bedeutet. Felder, Werkzeuge und Abläufe dürfen je nach Review-Frage und Teamkontext variieren; entscheidend sind konsistente Regeln und eine durchgehende Verbindung zur Quelle.
Inhaltsverzeichnis
Ein konsistentes System zur Organisation ausgewählter Studien einrichten
Legen Sie das Organisationssystem für ausgewählte Studien fest, bevor detaillierte Forschungsnotizen oder die Evidenzextraktion beginnen, damit jeder Studieneintrag denselben grundlegenden Regeln für Identifikation, Speicherung, Auffindbarkeit und Aktualisierung folgt.
Eine gemeinsame Einrichtung unterstützt die Konsistenz und erleichtert den späteren Vergleich, da die Einträge innerhalb desselben Arbeitsablaufs erstellt werden, anstatt für jede Studie unterschiedlich zusammengestellt zu werden.
Diese Organisation beginnt, sobald relevante Quelleneinträge aus der Literaturrecherche vorliegen.
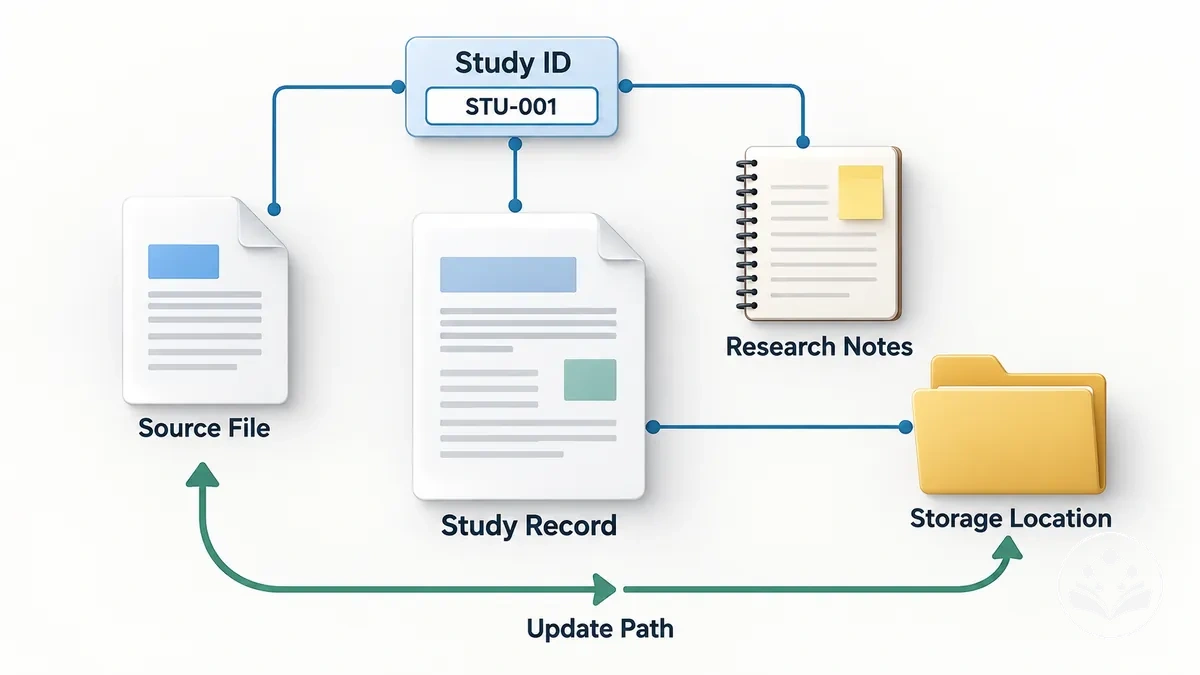
Die Einrichtungssequenz legt fest, wie Kennungen, Einträge, Dateien und Notizen verbunden werden, bevor das System mit den nach der Studienauswahl eingeschlossenen Studien befüllt wird.
Die begleitende Abbildung zeigt die Architektur dieser Verbindung, einschließlich der stabilen Studienkennung, des Studieneintrags, des Dateispeicherorts, des Notizenspeicherorts und des Aktualisierungspfads.
- Definieren Sie die Einheit des Eintrags. Entscheiden Sie, was ein Eintrag im Rahmen des Reviews repräsentiert, beispielsweise eine einzelne Publikation oder eine Studie, die mit mehreren Berichten verknüpft ist. Die geeignete Einheit hängt von der Art des Reviews ab und bestimmt, wie zusammengehöriges Quellenmaterial gruppiert wird.
- Weisen Sie eine stabile Studienkennung zu. Geben Sie jedem Eintrag eine Kennung, die unverändert bleibt, während Notizen und Evidenz hinzugefügt werden. Die Verwendung derselben Studienkennung über Einträge, Dateien und Notizen hinweg unterstützt die Rückverfolgbarkeit und erleichtert die Auffindbarkeit.
- Wählen Sie die Kernfelder. Legen Sie die Informationen fest, die jeder Studieneintrag enthalten soll, sodass äquivalente Informationen konsistent erfasst und später verglichen werden können. Die genauen Kernfelder können je nach Fragestellung und Review-Typ variieren. Definieren Sie daher die gemeinsamen Felder, ohne die detaillierte Evidenzextraktion vorwegzunehmen.
- Definieren Sie Datei- und Notizenspeicherorte. Geben Sie an, wo Quelldateien, Studieneinträge und Forschungsnotizen abgelegt werden und wie diese Speicherorte mit der Studienkennung verbunden sind. Definierte Speicherorte reduzieren unnötige Duplikate und erleichtern das Erkennen von falsch abgelegten oder nicht zugeordneten Materialien.
- Legen Sie eine Namenskonvention fest. Verwenden Sie eine konsistente Namenskonvention für Dateien und Einträge, die die stabile Studienkennung bewahrt und bei Bedarf zusammengehörige Materialien unterscheidet. Die Konvention kann die Softwareumgebung des Teams widerspiegeln, sofern dieselbe Regel im gesamten gewählten Arbeitsablauf angewendet wird.
- Definieren Sie eine Aktualisierungsroutine. Entscheiden Sie, wie Änderungen an Studieneinträgen, Notizen und gespeicherter Evidenz erfasst und abgeglichen werden. Bei kollaborativen Reviews kann die Routine auch festlegen, wer gemeinsame Einträge aktualisiert und wie Änderungen abgeglichen werden; bei einem Einzelreview kann eine einfachere Routine ausreichen. Überprüfen Sie, ob eine Studienkennung von ihrem Eintrag zu den zugehörigen Dateien und Notizen verfolgt werden kann, bevor detaillierte Einträge befüllt werden.
Stabile Kennungen und konsistente Kernfelder unterstützen die Rückverfolgbarkeit, da zusammengehöriges Material demselben Studieneintrag zugeordnet bleibt, während definierte Speicher- und Namensregeln die Auffindbarkeit vorhersagbarer machen.
Diese Regeln können doppelte oder nicht zugeordnete Dateien reduzieren und eine konsistente Grundlage für Vergleiche schaffen, ohne dass eine bestimmte Softwareanwendung erforderlich ist.
Sobald die Einheit des Eintrags, die Kennungen, die Kernfelder, die Speicherorte, die Namenskonvention und die Aktualisierungsroutine definiert sind, ist das System bereit für wiederholbare Studieneinträge.
Einen konsistenten Eintrag für jede Studie erstellen
Jede eingeschlossene Studie benötigt einen Studieneintrag mit derselben grundlegenden Struktur, damit ihre Identifikationsinformationen, Dateien, Notizen und der Arbeitsablaufstatus an vorhersehbaren Stellen gefunden werden können.
Weisen Sie eine stabile Studienkennung zu und halten Sie die Kernkategorien der Einträge über alle Studien hinweg konsistent.
Diese Struktur unterstützt die Auffindbarkeit und Prüfbarkeit, ohne den Eintrag in ein vollständiges Datenextraktionsprotokoll zu verwandeln.
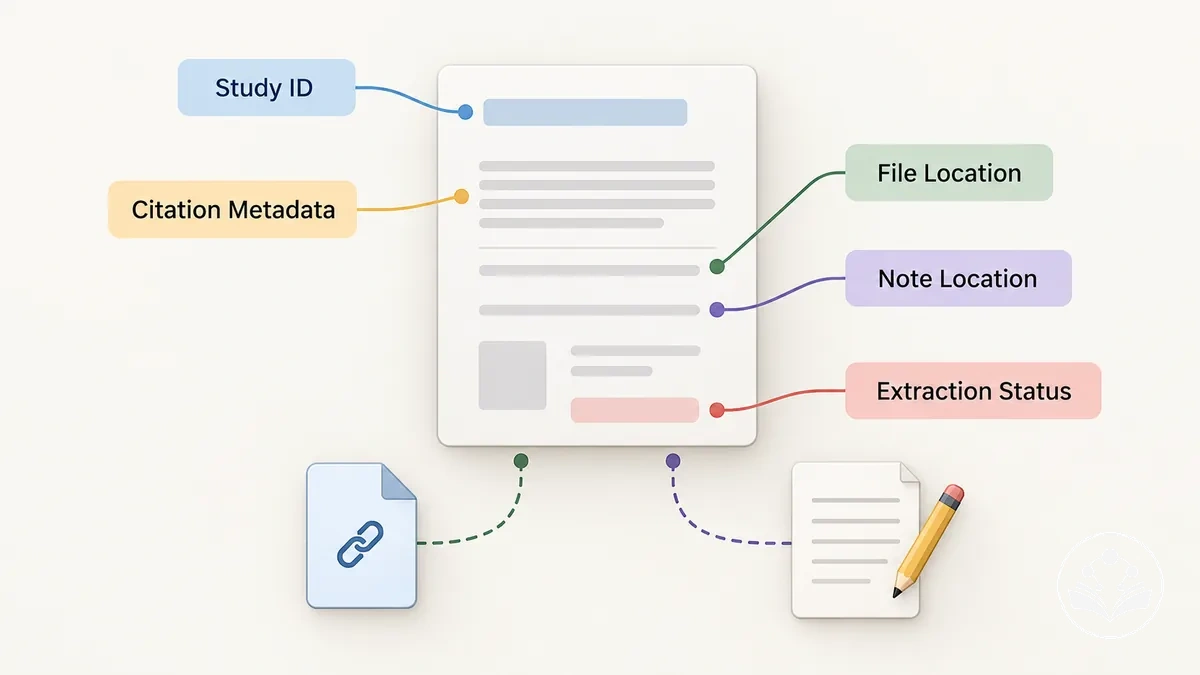
Das wiederholbare Eintragsmuster umfasst die Studienkennung, Zitationsmetadaten, Dateispeicherort, Notizenspeicherort und den Extraktionsstatus, sofern dieser Status für den Review-Arbeitsablauf relevant ist.
- Weisen Sie die Studienkennung zu. Geben Sie dem Studieneintrag eine eindeutige, stabile Kennung und verwenden Sie sie konsistent mit zugehörigen Dateien und Notizen, um Auffindbarkeit und Deduplizierung zu unterstützen.
- Erfassen Sie die Zitationsmetadaten. Speichern Sie die Zitationsinformationen, die zur Identifizierung der Quelle und zur Unterscheidung von anderen Studieneinträgen erforderlich sind, um eine konsistente Referenzprüfung und Prüfbarkeit zu unterstützen.
- Erfassen Sie den Dateispeicherort. Speichern Sie den Speicherort der Quelldatei oder einen anderen stabilen Speicherort, der im Review-Arbeitsablauf verwendet wird, sodass die Quelle über den Studieneintrag abgerufen werden kann.
- Erfassen Sie den Notizenspeicherort. Speichern Sie den Speicherort der Forschungsnotizen und verknüpfen Sie ihn, wo praktikabel, mit derselben Studienkennung, damit die Notizen mit dem korrekten Quelleneintrag verbunden bleiben.
- Aktualisieren Sie den Extraktionsstatus, sofern relevant. Kennzeichnen Sie den Studieneintrag mit seinem aktuellen Extraktionsstatus, wenn der Review-Arbeitsablauf diese Phase verfolgt, sodass der Eintrag anzeigt, ob bei der Evidenzextraktion noch Handlungsbedarf besteht.
Beispielsweise kann eine hypothetische Kennung wie STU-014 im Studieneintrag, im Quelldateinamen und im entsprechenden Notizeneintrag erscheinen.
Die Wiederverwendung derselben Kennung über diese Speicherorte hinweg erleichtert das Auffinden und Verknüpfen der zugehörigen Materialien bei späteren Aktualisierungen oder Vergleichen.
Quellenangaben, Studienmerkmale und Evidenz trennen
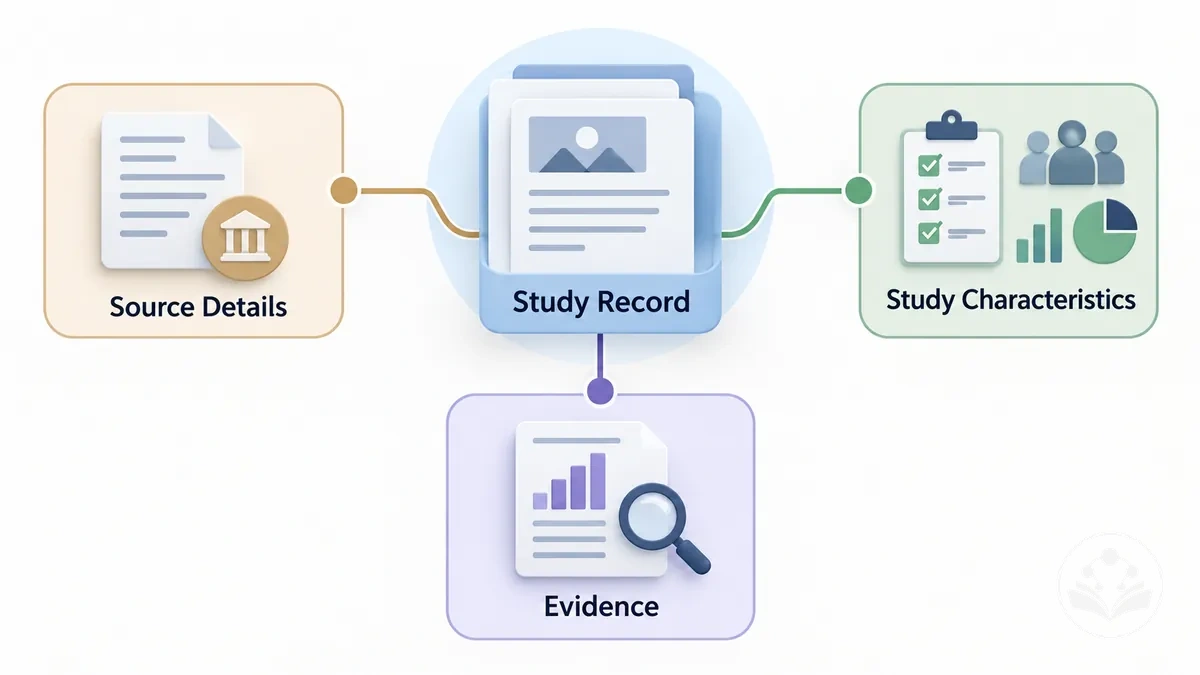
Quellenangaben, Studienmerkmale und Evidenz sind drei unterschiedliche Informationsklassen innerhalb eines Studieneintrags.
Quellenangaben enthalten bibliografische Angaben und Zitationsmetadaten, die die Quelle identifizieren und ihre Herkunft erhalten.
Studienmerkmale beschreiben die Studie durch Merkmale wie Design, Setting, Population oder Stichprobe, während Evidenz die Ergebnisse oder Daten erfasst, die für die Fragestellung des Reviews relevant sind.
Diese Trennung verhindert, dass Provenienzinformationen, Studienbeschreibungen und reviewrelevante Evidenz zu einer undifferenzierten Notiz vermischt werden.
Quellenangaben identifizieren und lokalisieren eine Studie; Studienmerkmale beschreiben sie; Evidenz erfasst, was für die Fragestellung des Reviews relevant ist.
Diese Trennung unterstützt die Rückverfolgbarkeit, indem die Provenienz mit der Quelle verbunden bleibt, den Vergleich, indem beschreibende Studienmerkmale getrennt gehalten werden, und die spätere Extraktion, indem reviewrelevante Ergebnisse von Identifikationsdaten getrennt werden.
Die Abbildung macht die Grenzen der Komponenten sichtbar und zeigt gleichzeitig, dass alle drei Informationsklassen zum selben Studieneintrag gehören.
| Informationsklasse | Typische Felder | Grund für die Trennung |
|---|---|---|
| Quellenangaben | Bibliografische Angaben, Zitationsmetadaten, Referenzinformationen, Provenienz | Identifiziert und lokalisiert die Quelle und hält ihre Herkunft nachvollziehbar. |
| Studienmerkmale | Design, Setting, Population oder Stichprobe | Beschreibt die Studie und unterstützt den Vergleich von Studienmerkmalen. |
| Evidenz | Ergebnisse oder Daten, die für die Fragestellung des Reviews relevant sind | Hält extrahierte Evidenz getrennt von Quellenidentifikation und beschreibenden Merkmalen für die spätere Extraktion und Interpretation. |
Die genauen Felder für Studienmerkmale und Evidenz sollten an die Disziplin, die Fragestellung des Reviews und das Design des Reviews angepasst werden, anstatt als feste Taxonomie behandelt zu werden.
Die drei Informationsklassen bleiben auch dann unterscheidbar, wenn sich die spezifischen Felder innerhalb jeder Klasse ändern.
Eine Literaturmatrix aufbauen, um Evidenz zu organisieren und zu vergleichen
Eine Literaturmatrix ist eine Organisations- und Vergleichsmethode, die vergleichbare Informationen aus mehreren Studien oder Quellen in einem gemeinsamen Raster anordnet.
Jede Studie bleibt ein eigener Evidenzeintrag, während gemeinsame Evidenzfelder relevante Merkmale und Ergebnisse nebeneinander sichtbar machen.
Die Matrix unterstützt den Vergleich vor der Synthese, ohne die Synthese selbst abzuschließen.
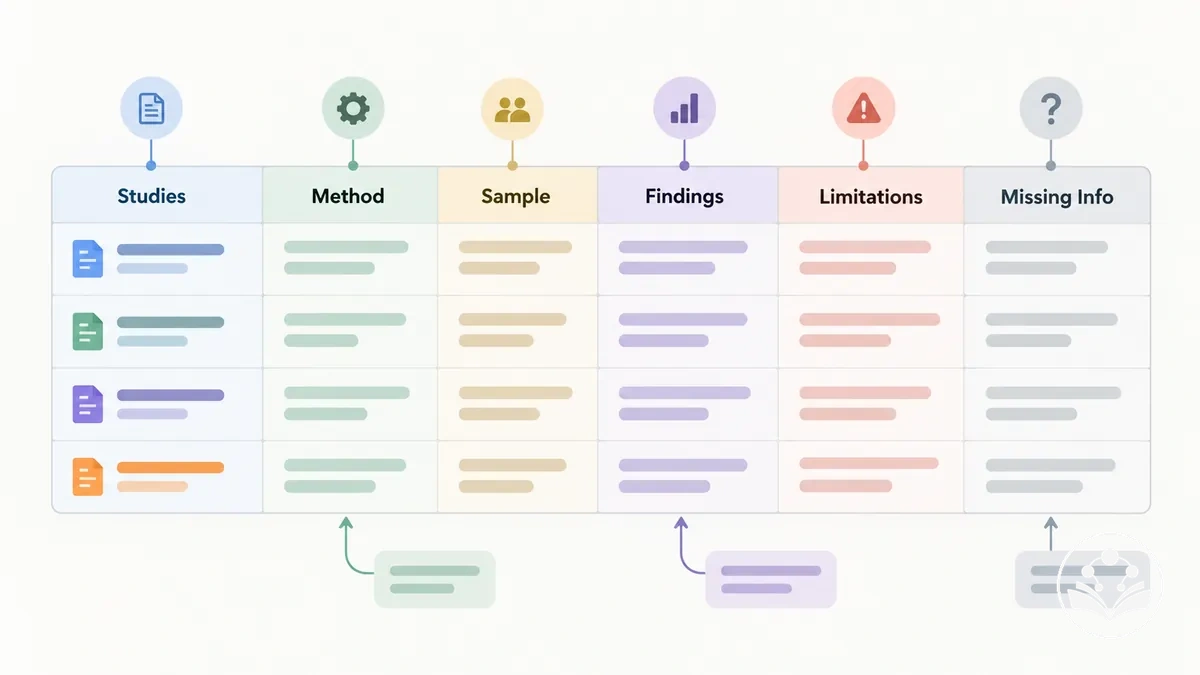
Studienzeilen und gemeinsame Spalten bieten eine konsistente Struktur für den Vergleich: Jede Zeile kann eine Studie repräsentieren, während Spalten Felder wie Methode oder Design, Stichprobe oder Population, relevante Ergebnisse und Einschränkungen erfassen können.
Diese Struktur folgt der Beziehung von Studie zu ausgewähltem Evidenzfeld zu erfasstem Wert oder Ergebnis und erleichtert die Untersuchung äquivalenter Informationen über mehrere Studien hinweg.
Das begleitende annotierte Beispiel zeigt, wie mehrere Studien über gemeinsame Vergleichsspalten hinweg ausgerichtet werden, ohne jeden Eintrag in der Tabelle wiederzugeben.
| Studie | Methode/Design | Stichprobe/Population | Relevantes Ergebnis | Einschränkung/Anmerkung |
|---|---|---|---|---|
| Studie A | Qualitative Interviews | Erwachsene Teilnehmer | Wiederkehrendes Thema berichtet | Einzelner Standort |
| Studie B | Querschnittsbefragung | Gemeindestichprobe | Anderes Muster berichtet | Evidenzfeld nicht berichtet |
| Studie C | Mixed-Methods-Studie | Definierte Studienpopulation | Verwandtes Ergebnis berichtet | Methodischer Unterschied vermerkt |
Muster können sichtbar werden, wenn vergleichbare Ergebnisse über Zeilen hinweg wiederkehren, während Unterschiede in Methoden, Stichproben oder berichteten Ergebnissen lokalisiert werden können, ohne die Studien in eine Schlussfolgerung zusammenzufassen.
Fehlende Informationen werden sichtbar, wenn ein gemeinsames Evidenzfeld für eine Studie keinen berichteten Wert aufweist.
Diese Signale identifizieren Material für die spätere Interpretation, aber sie etablieren selbst keine Themen, lösen keine Widersprüche auf oder legen Syntheseschlussfolgerungen fest.
Die Ausrichtung der Matrix und die Feldauswahl können je nach Fragestellung des Reviews, verfügbarer Evidenz und Arbeitsmethode variieren; Studien können unterschiedlich angeordnet werden, solange äquivalente Informationen konsistent vergleichbar bleiben.
Die Literaturmatrix fungiert daher als strukturierte Methode zur Organisation und zum Vergleich von Evidenz, während tiefere Interpretation und Synthese separate analytische Aufgaben bleiben.
Matrixfelder auswählen, die der Fragestellung des Reviews entsprechen
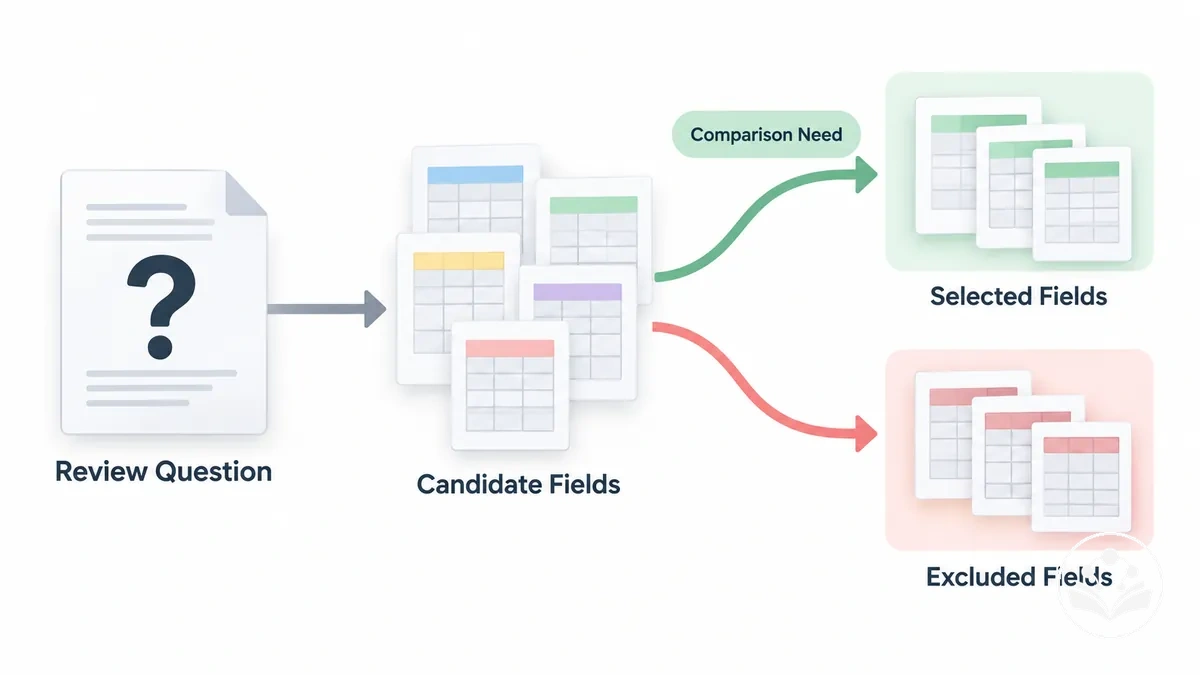
Matrixfelder sollten aufgenommen werden, wenn sie die Fragestellung des Reviews wesentlich unterstützen oder eine aussagekräftige Vergleichbarkeit über Studien hinweg ermöglichen.
Die Relevanz der Felder ist reviewspezifisch; eine Spalte, die für ein Review nützlich ist, kann für ein anderes entbehrlich sein.
Eine konsistente Feldauswahl legt fest, welche Studienmerkmale, Variablen, Ergebnisse, Themen oder andere Evidenzen später verglichen werden können, ohne anzunehmen, dass eine größere Anzahl von Feldern eine bessere Matrix ergibt.
Die Auswahlkriterien verbinden jedes Kandidatenfeld mit einer Aufnahmebedingung und einer analytischen Implikation.
Die begleitende Abbildung zeigt diese relevanzbasierte Entscheidung, indem sie die Fragestellung des Reviews mit Kandidatenfeldern, ausgewählten relevanten Feldern und ausgeschlossenen entbehrlichen Feldern verbindet.
- Relevanz für die Fragestellung des Reviews: Ein Feld aufnehmen, wenn sein Wert direkt zur Beantwortung der Fragestellung des Reviews oder zur Bewertung eines definierten Vergleichs beiträgt; andernfalls kann es zwar Informationen hinzufügen, aber nicht zur beabsichtigten Analyse beitragen.
- Konsistenz und Vergleichbarkeit: Ein Feld aufnehmen, wenn äquivalente Informationen über relevante Studien hinweg ausreichend identifiziert werden können, um einen aussagekräftigen Vergleich zu unterstützen; inkonsistente oder fehlende Daten können die Vergleichbarkeit des Feldes einschränken.
- Interpretierbarkeit: Ein Feld aufnehmen, wenn seine Werte im Review-Kontext eine ausreichend klare und konsistente Bedeutung haben; mehrdeutige Kategorien können die Interpretation von Unterschieden zwischen Studien erschweren.
- Extraktionsdurchführbarkeit: Ein Feld aufnehmen, wenn die erforderlichen Informationen in den verfügbaren Quellen mit ausreichender Konsistenz für die beabsichtigte Nutzung lokalisiert und extrahiert werden können; schlecht berichtete Informationen können zu erheblichen fehlenden Daten führen.
- Kernfelder: Verwenden Sie Kennungen und Studienmerkmale, wenn sie die Studienidentifikation oder einen Vergleich unterstützen, der über Einträge hinweg konsistent bleiben muss.
- Fragestellungsspezifische Felder: Verwenden Sie Variablen, Ergebnisse, Themen oder qualitätsrelevante Anmerkungen, wenn sie direkt mit den Zielen des Reviews und den beabsichtigten Vergleichen übereinstimmen.
Die Interventionsdauer kann beispielsweise ein nützliches Matrixfeld sein, wenn die Fragestellung des Reviews Ergebnisse nach Expositionslänge vergleicht, während der institutionelle Standort eines Autors interessant, aber entbehrlich sein kann, wenn kein definierter Bezug zu diesem Vergleich besteht.
Die Entscheidung, ein Feld aufzunehmen, sollte sich an Relevanz, Vergleichbarkeit, Konsistenz, Interpretierbarkeit und Extraktionsdurchführbarkeit orientieren und nicht an einem festen Satz von Spalten.
Methoden, Stichproben, Ergebnisse und Einschränkungen einheitlich erfassen
Vergleichbare Studieneinträge sollten dieselben beschreibenden Kategorien für Methoden, Stichproben, Ergebnisse und Einschränkungen verwenden, während sie bewahren, was jede Quelle tatsächlich berichtet.
Einheitliche Bezeichnungen können äquivalente Informationen leichter erfassbar machen, aber sie sollten die Bedeutung eines Studiendesigns, einer Population, eines Ergebnisses oder einer Studienbeschränkung nicht verändern.
Einheiten können standardisiert werden, wenn sie dieselbe Größe repräsentieren, während kontextuelle Zusätze erhalten bleiben sollten, wenn sie zur Interpretation studienspezifischer Informationen notwendig sind.
Die vier Informationsklassen sollten parallel erfasst werden, sodass Leser vergleichbare Merkmale auffinden können, ohne heterogene Studien so zu behandeln, als hätten sie identische Informationen berichtet.
- Methode/Design: Erfassen Sie die berichteten Methoden oder das Studiendesign mit einheitlichen Bezeichnungen, wenn die Terminologie ohne Bedeutungsänderung angeglichen werden kann; behalten Sie die quellenspezifische Designbeschreibung bei, wenn eine breitere Bezeichnung eine relevante Unterscheidung aufheben würde.
- Stichprobe/Population: Erfassen Sie die für den Vergleich benötigten Stichproben- oder Populationsinformationen, einschließlich berichteter Größe, Setting oder Teilnehmermerkmale, sofern relevant; verwenden Sie einheitliche Einheiten und Bezeichnungen, wo äquivalente Maße berichtet werden, während Sie kontextuelle Zusätze erhalten, die die Interpretation beeinflussen.
- Ergebnisse: Erfassen Sie Ergebnisse oder berichtete Resultate, die der Fragestellung des Reviews entsprechen, und unterscheiden Sie die von den Autoren berichtete Evidenz von der späteren Interpretation des Reviewers; standardisieren Sie äquivalente Einheiten oder Ergebnisbezeichnungen nur, wenn dies die ursprüngliche Bedeutung bewahrt.
- Einschränkungen: Erfassen Sie von der Studie berichtete Einschränkungen und behalten Sie Zusätze bei, die den Kontext erklären, in dem sie gelten; halten Sie jede vom Reviewer identifizierte Bedenke unterscheidbar, sodass eine gefolgerte Einschränkung nicht als berichtete Tatsache dargestellt wird.
Zwei heterogene Studien können beispielsweise unterschiedliche Studiendesignbezeichnungen und Populationsbeschreibungen beibehalten, während sie dieselben Eintragskategorien für Methode/Design, Stichprobe/Population, Ergebnisse und Einschränkungen verwenden.
Dieser Ansatz unterstützt die Vergleichbarkeit auf Kategorieebene, ohne unterschiedliche Evidenz in identische Werte zu zwingen oder studienspezifischen Kontext zu verwerfen.
Eine strukturierte Evidenzextraktionstabelle verwenden, wenn detaillierte Studiendaten erfasst werden müssen
Eine strukturierte Evidenzextraktionstabelle ist angezeigt, wenn ein Review eine systematische Datenextraktion wiederholter, reviewspezifischer Informationen aus eingeschlossenen Studien benötigt, die über den breiteren Vergleich hinausgeht, den eine allgemeine Literaturmatrix unterstützt.
Die Verwendung derselben Extraktionsstruktur über alle eingeschlossenen Studien hinweg unterstützt Konsistenz und Reproduzierbarkeit, indem die für die Erfassung ausgewählten Informationen explizit gemacht werden.
Sie kann auch selektive Erfassung reduzieren, indem relevante Felder im Voraus definiert werden, aber dieser Detaillierungsgrad ist nicht für jeden narrativen Review notwendig.
Die Evidenzextraktionstabelle sollte Felder erfassen, die der Fragestellung des Reviews dienen oder es ermöglichen, extrahierte Informationen anhand ihrer Quelle zu überprüfen.
Eine Studienkennung verbindet jede Zeile mit der eingeschlossenen Studie, während Informationen zur Population oder Stichprobe die relevante Studiengruppe erfassen.
Intervention oder Exposition wird nur erfasst, wenn das Review-Design eine solche untersucht, und das Outcome oder die Messgröße gibt an, was bewertet wurde.
Das Ergebnis erfasst die relevante berichtete Evidenz, während die Datenfundstelle die Herkunft sichert, indem sie angibt, wo diese Evidenz in der Quelle überprüft werden kann.
Extraktionsnotizen können notwendige kontextuelle Zusätze bewahren oder Extraktionsentscheidungen dokumentieren, ohne diese Notizen in ein Syntheseergebnis zu verwandeln.
| Studien-ID | Population/Stichprobe | Intervention/Exposition | Outcome/Messgröße | Ergebnis | Datenfundstelle | Extraktionsnotiz |
|---|---|---|---|---|---|---|
| Studie A | Berichtete Studienpopulation | Erfassen, wenn auf das Review-Design anwendbar | Review-relevante Messgröße | Berichtetes Ergebnis relevant für die Fragestellung des Reviews | Quellseite, Tabelle, Abbildung oder Abschnitt | Relevanter Zusatz oder Extraktionsentscheidung |
| Studie B | Berichtete Studienpopulation | Nicht anwendbar, wenn das Review-Design keine Intervention oder Exposition untersucht | Review-relevante Messgröße | Berichtetes Ergebnis relevant für die Fragestellung des Reviews | Quellseite, Tabelle, Abbildung oder Abschnitt | Relevanter Zusatz oder Extraktionsentscheidung |
Wenn der Extraktionsprozess komplex ist, testen oder prüfen Sie die Extraktionsstruktur an einer kleinen Gruppe eingeschlossener Studien vor dem großflächigen Einsatz, um festzustellen, ob die Felder zur Fragestellung des Reviews passen und konsistent angewendet werden können.
Passen Sie Felder an, die Mehrdeutigkeit erzeugen, notwendigen Kontext auslassen oder die Überprüfung nicht unterstützen, wobei die Grenze zwischen der Organisation extrahierter Daten und der formellen Synthese der Evidenz erhalten bleibt.
Forschungsnotizen mit ihren Quellen verbinden
Jede Forschungsnotiz sollte mit der Quelle und der Evidenz verbunden bleiben, die sie beschreibt, sodass ihre Zuordnung später verifiziert werden kann, ohne die Forschungsspur rekonstruieren zu müssen.
Die Notiz sollte die Studie identifizieren, auf den stabilsten verfügbaren Quellenverweis zeigen und unterscheiden, ob das aufgezeichnete Material ein Zitat, eine Paraphrase oder eine Interpretation des Forschenden ist.
Diese Verknüpfung unterstützt die Provenienz und Prüfbarkeit, ohne zu implizieren, dass ein Quellenverweis die Gültigkeit der zugrundeliegenden Behauptung beweist.
Die Notiz-Quelle-Verbindung kann mit vier wiederholbaren Schritten erstellt werden, die die Provenienz erhalten und Zuordnungsfehler reduzieren.
- Studienkennung zuweisen oder wiederverwenden. Verknüpfen Sie die Forschungsnotiz mit derselben Studienkennung, die für den Quelleneintrag verwendet wird, sodass die Notiz der korrekten Studie zugeordnet und anhand dieser Quelle überprüft werden kann.
- Notiz erfassen. Erfassen Sie die relevanten Informationen klar und halten Sie den von der Quelle berichteten Inhalt von der späteren Interpretation des Forschenden getrennt, sodass die Evidenzbasis identifizierbar bleibt.
- Quellenverweis erfassen. Fügen Sie den stabilsten verfügbaren Verweis hinzu, wie eine Seite, einen Abschnitt, eine Abbildung, eine Tabelle, einen Absatz oder eine andere quellspezifische Stelle, damit die Evidenz bei Bedarf direkt lokalisiert und überprüft werden kann.
- Evidenzstatus kennzeichnen. Markieren Sie die Notiz als Zitat, Paraphrase oder Interpretation des Forschenden, sodass berichtete Evidenz während der späteren Nutzung von analytischen Kommentaren des Reviewers unterscheidbar bleibt.
Überprüfen Sie vor der Verwendung einer Forschungsnotiz in der Analyse oder beim Schreiben, ob ihre Kennung, ihr Quellenverweis und ihr Evidenzstatus sie noch mit der unterstützenden Quelle verbinden.
Notizen und extrahierte Evidenz rückverfolgbar zu einzelnen Studien halten
Rückverfolgbarkeit bedeutet, von einer Forschungsnotiz oder einem extrahierten Wert zur genauen einzelnen Studie und, wo möglich, zur spezifischen Quellenstelle zurückgelangen zu können, die ihn stützt.
Ein rückverfolgbarer Eintrag bewahrt diesen Prüfpfad durch eine stabile Studienkennung und einen Quellenverweis, anstatt sich allein auf den Wortlaut der Notiz zu verlassen.
Die Verbindung stellt die Provenienz her und unterstützt die Überprüfung, aber sie begründet für sich genommen weder die Gültigkeit noch die Evidenzstärke des zugrundeliegenden Ergebnisses.
Minimaler Prüfpfad
- Studienkennung
- Verbindet Notiz oder extrahierten Datenpunkt mit dem korrekten Quelleneintrag.
- Fundstelle
- Zeigt, wo das unterstützende Material überprüft werden kann: bei stabiler Paginierung eine Seite, sonst beispielsweise Abschnitt, Abbildung, Tabelle, Absatz oder ein anderer zuverlässiger quellspezifischer Marker.
- Evidenztyp
- Kennzeichnet das Element als Zitat, Paraphrase, extrahierten Datenpunkt oder Interpretation, damit berichtete Ergebnisse und Interpretation des Review-Teams unterscheidbar bleiben.
Minimalanforderung: Kennung + Fundstelle + Evidenztyp müssen gemeinsam ausreichen, um das erfasste Element abzurufen und zu überprüfen.
Diese Rückverfolgbarkeit unterstützt die Prüfbarkeit innerhalb des Organisationssystems, ohne den Eintrag in eine zitierstilähnliche Anleitung zu verwandeln.
Ein illustrierender rückverfolgbarer Eintrag könnte beispielsweise Studien-ID STU-021 — Tabelle 2 — extrahierter Datenpunkt verwenden: Die Studienkennung identifiziert den Quelleneintrag, der Tabellenverweis liefert den Quellenverweis, und die Evidenztyp-Kennzeichnung identifiziert den Status des erfassten Elements.
Evidenz für die spätere Analyse gruppieren und kennzeichnen
Gruppieren und kennzeichnen Sie Evidenz mit stabilen, vorläufigen Kategorien, sodass zusammengehörige Ergebnisse für die spätere Analyse gemeinsam abgerufen werden können, ohne diese Kategorien als endgültige Syntheseschlussfolgerungen zu behandeln.
Die Gruppierung erleichtert die Untersuchung wiederkehrender Muster über die organisierte Evidenz hinweg, während die einzelnen Studien und Ergebnisse, die sie stützen, erhalten bleiben.
Relevante Gruppierungsdimensionen können ein Thema, ein Konzept, eine Population, eine Methode, ein Ergebnis, ein Kontext oder ein Zeitraum sein, wenn diese Dimension inhaltlich mit der Fragestellung des Reviews zusammenhängt.
Die Gruppierungssequenz geht von wiederkehrenden Merkmalen zu vorläufigen Bezeichnungen und dann zur Evidenzzuordnung, wobei jeder Schritt auf seine fortgesetzte Nützlichkeit überprüft wird.
- Wiederkehrende Dimensionen identifizieren. Sichten Sie die organisierte Evidenz auf wiederkehrende Themen, Konzepte, Populationen, Methoden, Ergebnisse, Kontexte oder Zeiträume, die die spätere Analyse unterstützen könnten. Prüfen Sie, ob jede vorgeschlagene Dimension eine definierte Beziehung zur Fragestellung des Reviews hat, anstatt nur wiederholt aufzutreten.
- Stabile Bezeichnungen definieren. Geben Sie jeder nützlichen Gruppe eine präzise Bezeichnung, die das gemeinsame Merkmal beschreibt, ohne eine endgültige analytische Schlussfolgerung zu kodieren. Prüfen Sie, ob die Bezeichnung konsistent angewendet werden kann und keine einmalige Kategorie für Evidenz schafft, der eine sinnvolle Gruppierungsbeziehung fehlt.
- Evidenz relevanten Gruppen zuordnen. Ordnen Sie jedes relevante Ergebnis oder Evidenzelement der zutreffenden Bezeichnung zu, sodass zusammengehöriges Material gemeinsam abgerufen werden kann. Prüfen Sie die Evidenz selbst, anstatt anzunehmen, dass eine Studie nur zu einer Gruppe gehört, da verschiedene Ergebnisse aus derselben Studie verschiedene analytisch relevante Gruppen stützen können.
- Nützlichkeit der Bezeichnungen überprüfen. Prüfen Sie, ob die Gruppen ausreichend unterscheidbar bleiben, um die Auffindbarkeit und den Vergleich zu unterstützen, während mehr Evidenz zugeordnet wird. Achten Sie auf Bezeichnungen, die sich unnötig überschneiden, eng verwandte Evidenz aufspalten oder keine nützliche Unterscheidung mehr für die Fragestellung des Reviews darstellen, und passen Sie sie bei Bedarf an.
Beispielsweise kann eine Studie Evidenz zu einer Populationsgruppe und einer Ergebnisgruppe beitragen, wenn separate Ergebnisse in dieser Studie für beide Dimensionen relevant sind; die Zuordnungen identifizieren Abrufpfade, anstatt endgültige Themen zu deklarieren.
Vorläufige Evidenzgruppen sind nicht automatisch die endgültige Manuskriptstruktur. Die Gruppierung für Auffindbarkeit und spätere Analyse ist von der Entscheidung für eine thematische oder chronologische Gliederung des geschriebenen Reviews zu unterscheiden.
Die Gruppen sollten daher vorläufige Organisationshilfen bleiben, bis die spätere Analyse bestimmt, wie die Evidenz interpretiert und dargestellt werden soll.
Kategorien und Tags verwenden, um zusammengehörige Evidenz zusammenzuhalten
Kategorien und Tags schaffen eine kontrollierte Abrufschicht über organisierte Evidenz.
Breite Kategorien repräsentieren Hauptgruppierungen, während engere Tags wiederverwendbare Merkmale oder Unterthemen kennzeichnen, die über mehrere Studien hinweg anwendbar sind.
Diese Unterscheidung hilft, zusammengehörige Evidenz auffindbar zu halten, ohne organisatorische Bezeichnungen in endgültige analytische Themen zu verwandeln.
Das Kennzeichnungssystem sollte explizite Regeln für Benennung, Granularität, Konsistenz, Synonymkontrolle und mehrere Tags verwenden, sodass Klassifikationsbezeichnungen wiederverwendbar bleiben, ohne die Evidenz zu fragmentieren.
- Benennung: Verwenden Sie klare, beschreibende Bezeichnungen, die das gruppierte Evidenzmerkmal widerspiegeln, und vermeiden Sie Abkürzungen, die beim späteren Abruf mehrdeutig sein könnten.
- Granularität: Halten Sie Kategorien breit genug, um zusammengehörige Evidenz zu sammeln, und Tags spezifisch genug, um wiederverwendbare Merkmale zu unterscheiden; übermäßig enge Tags können Evidenz in einmalige Bezeichnungen fragmentieren.
- Konsistenz: Wenden Sie dieselbe Bezeichnung für dasselbe Konzept im gesamten Evidenzsatz an, sodass der Abruf nicht von Formulierungsvarianten abhängt.
- Synonymkontrolle: Wählen Sie eine bevorzugte Bezeichnung für äquivalente Begriffe und wenden Sie sie konsistent an; überlappende Synonyme können zusammengehörige Evidenz über getrennte Abrufpfade aufspalten.
- Mehrere Tags: Wenden Sie mehr als einen Tag an, wenn ein Ergebnis tatsächlich mehrere wiederverwendbare Merkmale betrifft, vorausgesetzt, jeder Tag hat einen definierten Zweck und kodiert keine ungestützte Schlussfolgerung.
Eine breite Kategorie wie Population könnte beispielsweise engere wiederverwendbare Tags wie Jugendliche, ältere Erwachsene und Pflegende verwenden, wenn diese Unterscheidungen für die Fragestellung des Reviews relevant sind.
Die nützliche Granularität hängt vom Evidenzbestand und vom Abrufbedarf ab. Kategorien und Tags sollten deshalb kontrollierte organisatorische Bezeichnungen bleiben und weder als universelle Taxonomie noch als Ersatz für die spätere thematische Analyse dienen.
Referenzmanagement, Dateien und Evidenzeinträge koordinieren
Ein Referenzmanager, Quelldateien, Forschungsnotizen und Evidenzeinträge erfüllen unterschiedliche Funktionen, sollten aber als verbundene Ebenen desselben Dokumentations-Workflows zusammenarbeiten.
Der Referenzmanager organisiert in erster Linie Zitationsmetadaten und Quellenbeziehungen, Dateien bewahren die konsultierten Dokumente, Forschungsnotizen erfassen quellenverknüpfte Anmerkungen und Interpretationen, und Evidenzeinträge tragen Informationen, die für den Vergleich mit der Fragestellung des Reviews ausgewählt wurden.
Die Koordination erfolgt durch die Verwendung einer stabilen Studienkennung oder eines Zitationsschlüssels über diese Ebenen hinweg, anstatt zu erwarten, dass ein Repository alle Funktionen übernimmt.
Die funktionale Trennung hilft, die bibliografische Kontrolle von der fragestellungsspezifischen Evidenz getrennt zu halten, während die Verbindungen zwischen den Aufzeichnungen erhalten bleiben.
Referenzmanagement-Software wie Zotero kann – je nach Softwareversion und Konfiguration – Zitationsmetadaten, Sammlungen, Tags, Anhänge und Annotationen unterstützen.
Die Quelldateispeicherung hält PDFs oder andere Dokumentdateien vor, während Forschungsnotizen kontextuelle Beobachtungen und Quellenverweise zu diesen Dokumenten festhalten.
Ein Evidenzeintrag oder eine Evidenzmatrix trägt die Studienmerkmale und extrahierten Evidenzen, die für den reviewspezifischen Vergleich benötigt werden.
Die Studienkennung bietet den Verbindungspunkt, der es ermöglicht, Informationen aus verschiedenen Werkzeugen oder Speicherorten derselben Studie zuzuordnen.
| Workflow-Ebene | Primäre Aufgabe | Typische Inhalte | Verbindungsschlüssel |
|---|---|---|---|
| Referenzmanager | Bibliografische Einträge und Quellenbeziehungen organisieren | Zitationsmetadaten, Sammlungen, Tags, Anhänge und Annotationen, wo unterstützt | Studienkennung oder Zitationsschlüssel, die dem Referenzeintrag zugeordnet ist |
| Quelldateien | Die als Evidenzquellen genutzten Dokumente speichern | PDFs oder andere Quelldokumente mit konsistenter Dateibenennung und Speicherorten | Studienkennung oder Zitationsschlüssel im Dateinamen oder zugehörigen Eintrag |
| Forschungsnotizen | Kontextuelle Notizen und Interpretationen mit Quellen verbunden halten | Annotationen, Paraphrasen, Interpretationen und Quellenverweise | Studienkennung oder Zitationsschlüssel, die mit der Notiz verknüpft ist |
| Evidenzeintrag/-matrix | Reviewspezifische Informationen für den Vergleich organisieren | Relevante Studienmerkmale, extrahierte Ergebnisse und fragestellungsspezifische Evidenzfelder | Studienkennung oder Zitationsschlüssel, die mit der Matrixzeile erfasst wird |
Eine hypothetische Studienkennung wie STU-021 kann beispielsweise dem Referenzeintrag zugeordnet, in den PDF-Dateinamen aufgenommen, mit den Forschungsnotizen verknüpft und in die entsprechende Zeile des Evidenzeintrags oder der Matrix eingetragen werden.
Die gemeinsame Kennung ermöglicht die Verbindung dieser Aufzeichnungen, selbst wenn sie in verschiedenen Werkzeugen oder Speicherorten abgelegt sind.
Jede Ebene kann daher ihre primäre Funktion behalten, während die koordinierte Kennung die Beziehung zwischen Referenz, Dateien, Notizen und extrahierter Evidenz bewahrt.
Die organisierte Evidenz vor der Synthese prüfen
Die organisierte Evidenz sollte vor der Synthese überprüft werden, damit fehlende Einträge, inkonsistente Felder, unterbrochene Quellenverweise oder mehrdeutige Bezeichnungen nicht unbemerkt in den späteren Vergleich gelangen.
Evidenz ist analysereif, wenn die für den Review erforderlichen Einträge ausreichend vollständig, konsistent strukturiert und rückverfolgbar zu ihren Quellen sind.
Lücken können bestehen bleiben, wenn die Quelle die Informationen nicht bereitstellt oder das Review-Design fehlende Werte zulässt, aber diese Lücken sollten explizit dokumentiert und nicht durch Rückschlüsse gefüllt werden.
Die Bereitschaftsprüfung testet die Studienabdeckung, Vollständigkeit, Duplikatskontrolle, Konsistenz, Rückverfolgbarkeit, Provenienz, Kategorien- oder Tag-Kohärenz sowie ungeklärte fehlende Werte.
Jede Prüfung sollte ein bestandenes Signal und eine Korrekturmaßnahme identifizieren, wenn die Bedingung nicht erfüllt ist.
Zweck ist die Überprüfung des organisierten Evidenzsystems, nicht die Bewertung der Manuskriptqualität oder die methodologische Beurteilung.
- Studienabdeckung: Prüfen, ob jede für die Analyse vorgesehene Studie einen entsprechenden Evidenzeintrag hat. Die Prüfung ist bestanden, wenn die eingeschlossenen Studien in der organisierten Evidenz nachgewiesen werden können; fehlt ein Eintrag oder kann nicht zugeordnet werden, stellen Sie ihn wieder her, klären Sie ihn oder kennzeichnen Sie ihn explizit, bevor Sie fortfahren.
- Vollständigkeit der Pflichtfelder: Prüfen, ob die als notwendig für den Review definierten Felder dort ausgefüllt wurden, wo die Quelle die erforderlichen Informationen bereitstellt. Die Prüfung ist bestanden, wenn die erforderlichen Informationen erfasst oder eine begründete Abwesenheit explizit markiert ist; klären Sie ungeklärte Leerstellen, anstatt sie durch Rückschlüsse zu füllen.
- Duplikatskontrolle: Prüfen, ob doppelte Einträge oder mehrere Berichte zur selben Studie nicht unbeabsichtigt als unabhängige Evidenz behandelt wurden. Die Prüfung ist bestanden, wenn die Beziehungen zwischen Einträgen klar sind; führen Sie unbeabsichtigte Duplikate zusammen, verknüpfen Sie sie oder gleichen Sie sie anderweitig ab, während Sie eigenständige Quelleneinträge erhalten, wenn diese tatsächlich erforderlich sind.
- Feldkonsistenz: Prüfen, ob äquivalente Informationen mit konsistenten Bezeichnungen, Kategorien, Einheiten und kontextuellen Zusätzen erfasst werden, wo die Standardisierung die Quellenbedeutung bewahrt. Die Prüfung ist bestanden, wenn vergleichbare Felder konsistent interpretiert werden können; korrigieren Sie inkonsistente Einträge oder dokumentieren Sie studienspezifische Unterschiede, die unterscheidbar bleiben sollten.
- Notiz-Quelle-Verknüpfung: Prüfen, ob Forschungsnotizen die Studienkennung und einen geeigneten Quellenverweis enthalten, wo verfügbar. Die Prüfung ist bestanden, wenn eine Notiz zu ihrer unterstützenden Quelle zurückverfolgt werden kann; verbinden Sie losgelöste Notizen neu oder kennzeichnen Sie sie, bevor Sie sie als analysereif behandeln.
- Evidenzprovenienz: Prüfen, ob extrahierte Ergebnisse oder Werte mit der Studie und dem Quellenort verbunden bleiben, aus dem sie entnommen wurden. Die Prüfung ist bestanden, wenn die Evidenzspur die Überprüfung unterstützt; stellen Sie fehlende Provenienz wieder her oder kennzeichnen Sie das Evidenzelement, wenn seine Herkunft nicht ermittelt werden kann.
- Kategorien- oder Tag-Kohärenz: Prüfen, ob Kategorien und Tags konsistent angewendet werden und ob überlappende Bezeichnungen zusammengehörige Evidenz nicht unnötig fragmentieren. Die Prüfung ist bestanden, wenn äquivalente Konzepte die vorgesehenen Bezeichnungen verwenden; gleichen Sie mehrdeutige Synonyme ab oder dokumentieren Sie begründete Unterscheidungen.
- Ungeklärte fehlende Werte: Prüfen Sie verbleibende fehlende Werte, um festzustellen, ob sie auf fehlende Berichterstattung, Nichtanwendbarkeit oder ein ungeklärtes Eintragsproblem zurückzuführen sind. Die Prüfung ist bestanden, wenn jede inhaltliche Lücke einen expliziten Status hat; klären Sie, was geklärt werden kann, und kennzeichnen Sie begründetes Fehlen, ohne einen Wert zu schätzen.
Mehrdeutige oder unvollständige Einträge sollten geklärt werden, wo die Quelle dies zulässt, dokumentiert werden, wenn eine Unterscheidung bestehen bleiben muss, oder explizit gekennzeichnet werden, wenn Informationen nicht ermittelt werden können.
Eine gekennzeichnete Lücke kann in einem analysereifen Datensatz verbleiben, wenn ihr Status klar ist und das Review-Design keinen aufgelösten Wert für dieses Feld erfordert.
Sobald die erforderlichen Einträge ausreichend vollständig, konsistent und rückverfolgbar sind und offene Zustände eindeutig gekennzeichnet wurden, ist der organisierte Datensatz bereit, um Evidenz zu synthetisieren.
Vollständigkeit, Konsistenz und Quellenrückverfolgbarkeit prüfen
Vollständigkeit, Konsistenz und Quellenrückverfolgbarkeit sind getrennte Bereitschaftskriterien, da sie unterschiedliche Probleme in organisierter Evidenz aufdecken.
Vollständigkeit prüft, ob die erforderlichen Einträge und Pflichtfelder vorhanden sind oder fehlende Werte einen eindeutigen Status erhalten haben.
Konsistenz prüft, ob äquivalente Informationen stabilen Bezeichnungen, Formaten und Codierungsregeln folgen, während Quellenrückverfolgbarkeit prüft, ob Evidenz und Notizen eine überprüfbare Quellenverbindung zur einzelnen Studie behalten.
Die Kriterien sollten entsprechend dem Review-Design interpretiert werden, anstatt anzunehmen, dass jedes Feld einen inhaltlichen Wert enthalten muss.
Eine Leerstelle kann bedeuten, dass die Quelle die Information nicht berichtet, das Feld nicht anwendbar ist oder die Information noch nicht extrahiert wurde; diese Zustände erfordern unterschiedliche Korrekturen.
Stabile Bezeichnungen und Codierungsregeln unterstützen die Konsistenz, wenn äquivalente Informationen auf die gleiche Weise erfasst werden, während begründete studienspezifische Unterschiede unterscheidbar bleiben können.
Quellenrückverfolgbarkeit ist akzeptabel, wenn ein Evidenzelement oder eine Notiz über eine Studienkennung und eine Quellenverbindung oder einen Quellenverweis mit dem unterstützenden Eintrag verbunden werden kann.
Diese Kriterien unterstützen ein Bereitschaftsurteil, ohne eine universelle Vollständigkeitsschwelle vorzugeben.
| Kriterium | Prüfgegenstand | Akzeptabler Zustand | Korrekturmaßnahme |
|---|---|---|---|
| Vollständigkeit | Erforderliche Einträge, Pflichtfelder und der Status fehlender Werte | Erforderliche Informationen sind erfasst, wo verfügbar, und fehlende Werte sind explizit als in der Quelle nicht berichtet, nicht-anwendbar oder noch-nicht-extrahiert gekennzeichnet, wenn diese Unterscheidung zutrifft | Unvollständige Extraktion abschließen, fehlende erforderliche Einträge wiederherstellen oder den korrekten Status für den fehlenden Wert zuweisen, anstatt einen Wert zu schätzen |
| Konsistenz | Stabile Bezeichnungen, Formate, Einheiten und Codierungsregeln für äquivalente Informationen | Äquivalente Informationen folgen denselben Erfassungsregeln, während begründete quellspezifische Unterschiede klar unterscheidbar bleiben | Inkonsistente Bezeichnungen oder Formate standardisieren, wo die Bedeutung erhalten bleibt, oder dokumentieren, warum eine abweichende Darstellung notwendig ist |
| Quellenrückverfolgbarkeit | Verbindungen zwischen Evidenz, Forschungsnotizen, der Studienkennung und dem unterstützenden Quellenort | Jedes inhaltliche Element kann zur einzelnen Studie und, wo verfügbar, zu einem verlässlichen Quellenverweis zurückverfolgt werden | Fehlende Quellenverbindung oder Quellenverweis wiederherstellen, das Element dem korrekten Studieneintrag zuordnen oder das Element explizit kennzeichnen, wenn die Provenienz nicht ermittelt werden kann |
Wenn beispielsweise ein Ergebnisfeld leer ist, weil die Quelle dieses Ergebnis nicht berichtet, kennzeichnen Sie den Wert als „in der Quelle nicht berichtet“. Ergänzen Sie kein Ergebnis durch Rückschluss und behandeln Sie den Eintrag nicht automatisch als unvollständig.
Ist ein Feld dagegen als „noch nicht extrahiert“ markiert, kennzeichnet es unerledigte Arbeit, die vor der Einstufung als analysereif abgeschlossen werden sollte.